arm64:用 sme_active_cpus 掩码替代 mm_cpumask 采样 — 恢复 C1-Pro SME DVMSync erratum 下的 TLB 回收批量收益
💡 一句话总结
在带 C1-Pro SME DVMSync erratum(ARM64_ERRATUM_4193714)的 Arm 服务器上,上一版 erratum workaround(0baba94a9779)在页面回收(kswapd)的批量 TLB 刷路径里,为了安全采样 mm_cpumask() 给每一次批量都硬加了一次 dsb(ish) 屏障,把“多页凑一批、只同步一次”的批量收益打散,合入说明指出造成 kswapd 约 30% 性能回归(数据来自 arm64-fixes 合并请求摘要)。本补丁改用全局 sme_active_cpus 掩码(跟踪哪些 CPU 正以 SME 用户态运行)替代逐 mm 的 cpumask 采样:批量刷完成时直接对该掩码发一次 IPI,删掉每次批量的 DSB、每任务 cpumask 分配与相关生命周期管理(净删 87 行),恢复批量收益、修复该回归。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能回归修复 + 简化重构)——主导为修复 0baba94a9779 erratum workaround 引入的 kswapd 性能回归;同时是纯删减重构(+17/-87 行) |
| 状态 | 状态(Merged)· 合入版本:Linux 7.2(git describe --contains 显示首个含此 commit 的 tag 为 v7.2-rc3) |
| 当前版本 | 主线单版本(经 arm64-fixes 标签合入)· 合入版链接 |
| 版本演进 | 首版,暂无多版本系列可回溯(lore MCP 本环境不可用,见“方案演进”数据源说明) |
| 作者机构 | Catalin Marinas(Arm,arm64 维护者)<catalin.marinas@arm.com> |
| 提交日期 | 2026-06-10(committed);2026-07-10 经 arm64-fixes 标签合入 v7.2-rc3(merge commit d96fcfe1b7f9) |
| 改动范围 | arch/arm64/include/asm/tlbbatch.h + arch/arm64/include/asm/tlbflush.h + arch/arm64/kernel/fpsimd.c + arch/arm64/kernel/process.c,+17/-87 行,4 文件 |
| 核心函数 | sme_dvmsync_batch() / sme_set_active() / sme_clear_active() / arch_tlbbatch_add_pending() |
| 原始链接 | git.kernel.org(规范 commit 链接) |
| Fixes 链 | Fixes: 0baba94a9779(“arm64: errata: Work around early CME DVMSync acknowledgement”,2026-04 合入) |
| Review / 测试 | Cc: Will Deacon(arm64 维护者)· Tested-by: Joshua Liu(Google)· Signed-off-by: Will Deacon |
📊 速览卡片
特性等级依据:修复的是 30% kswapd 回归、幅度显著且纯删减(+17/-87),兼容性极好(无行为破坏、非 erratum 硬件 no-op)——但收益场景窄(仅 C1-Pro SME 硬件 + 内存回收批量刷路径),30% 数字来自合入说明而非 commit 内独立 benchmark,故未给更高星,综合 ★★★。
🎯 解决什么问题
TLBI + DSB 已经完成后仍可能用过期的地址翻译访问设备内存。2026-04 合入的首版 workaround(0baba94a9779)的思路:在做 TLB 维护时,对正以 SME 用户态运行的 CPU 补发一次 IPI——IPI 处理器为空函数,靠
SCTLR_EL1.IESB=1 下“取异常到 EL1”即完成 SME 内存访问这一性质,无需显式 DSB。同时为了避免恶意程序(如 madvise(MADV_PAGEOUT) 死循环)触发 IPI 风暴,它用 mm_cpumask() 跟踪“进程活跃在哪些 CPU”,只打断这些 CPU。问题出在这个 workaround 与批量 TLB 刷(reclaim batching)的交互:workaround 从
arch_tlbbatch_add_pending() 采样 mm_cpumask(),而为了让该读取在硬件 DVMSync 之后有序,每批都要先做一次 dsb(ish)——这正好抵消了“批量刷”想省的 DSB 同步等待。合入说明(arm64-fixes 合并请求摘要)明确记载:这造成 30% 的 kswapd 性能回归。
arch/arm64/include/asm/tlbflush.h 的批量刷接口:①
arch_tlbbatch_add_pending()(每 unmap 一页调用一次):只发逐页 TLBI,不同步——这是批量刷的核心:把“每页 TLBI;DSB”折叠成“多页只 TLBI,最后统一一次 DSB”,省掉每页等 DSB 的时间。② 旧 workaround 在这条路径里额外调了
sme_dvmsync_add_pending():先 dsb(ish)(让 mm_cpumask() 读取在硬件 DVMSync 之后有序),再把 mm_cpumask(mm) 累加进每任务(tlb_ubc)的 batch cpumask(首次使用时 zalloc_cpumask_var(GFP_ATOMIC) 分配)。③ 于是每一批(无论是否真有 SME 进程在跑,只要硬件是 C1-Pro)都多一次
dsb(ish) 屏障 + 一次 cpumask 读取/累加。页面回收(kswapd)的 unmap 路径批量小而频繁,这次多出的屏障开销在回收热路径上被放大成 30% 回归。④ 代码负担不止性能:还要在任务复制/释放时管理 batch cpumask 的生命周期(
arch_dup_tlbbatch_mask / arch_release_tlbbatch_mask,process.c),并处理 CPUMASK_OFFSTACK 两种布局。
try_to_unmap / 直接回收)在 PTL 下批量 unmap 匿名/文件页,用 tlb_ubc(per-task tlbflush_unmap_batch)缓存待刷 TLB,攒够一批后在 try_to_unmap_flush() 统一 arch_tlbbatch_flush()(mm/rmap.c)——这是 arm64 上 CONFIG_ARCH_WANT_BATCHED_UNMAP_TLB_FLUSH 的标准回收路径。高频触发场景:任何持续内存压力下的服务器——数据库/容器/内存密集型负载在回收线程(kswapd)与进程直接回收中高频触发该路径;回收越频繁、批量越小,每批一次 DSB 的占比越高。
为什么该场景踩中系统缺陷:批量刷的收益本质是“省掉每页一次 DSB 等待”;旧 workaround 在每一批末尾再塞一次 DSB,等于把“批量”省下的同步重新交回去,且完全不区分“此刻是否有进程正以 SME 运行”——这是设计层面的结构性开销,不是偶发。
硬件前提:仅
CONFIG_ARM64_ERRATUM_4193714(C1-Pro,依赖 ARM64_SME,default y)且 CPU 实际带该勘误时生效(alternative_has_cap_unlikely 运行时检查);非 C1-Pro 上旧路径同样每批做 dsb(ish) 却无 DVMSync 可等,白白付出屏障成本。
🧩 核心机制
一句话机制:用一个全局 sme_active_cpus 掩码(跟踪“哪些 CPU 此刻正以 SME 用户态运行”)替代“每批采样 mm_cpumask() 并累加”。这个全局掩码在 SME 用户态进出时(sme_set_active() / sme_clear_active())就维护好了,程序序保证它先于用户态 SME 访问可见——所以批量刷完成时直接读它并发 IPI 即可,无需每次批量再 dsb(ish)。
mm_cpumask + DSB 排序);新设计把这份信息变成始终新鲜、随时可读的全局状态。sme_set_active()(返回 SME 用户态前/ERET 前)把当前 CPU 置入 sme_active_cpus(同时仍置 mm_cpumask(current->mm) 供非批量路径 sme_dvmsync(mm) 使用);sme_clear_active()(异常进入 EL1,IESB=1 保证 SME 访问已完成)清掉两处。这两个函数本就是旧 workaround 在 fpsimd.c 里已有的,本补丁只是让它们顺带维护新掩码——增量开销只有一次 cpumask 位操作。② 批量路径不再“记账”,只在一个时点做一次广播:
sme_dvmsync_batch() 从“对累加的 per-batch cpumask 发 IPI”改为“对全局 sme_active_cpus 发 IPI”。批量结束时唯一的同步开销仍是原有的 dsb(ish) + __repeat_tlbi_sync(vale1is, 0)(完成逐页 TLBI),DVMSync workaround 的 IPI 在之后顺带发出。取舍:sme_active_cpus 是超集——它包含“任何正运行 SME 进程的 CPU”,而不只“被 unmap 的 mm 所在 CPU”,可能多打断个别 CPU(但只限 SME 活跃的小集合),换来的是批量热路径上每批一次 DSB 的彻底移除。
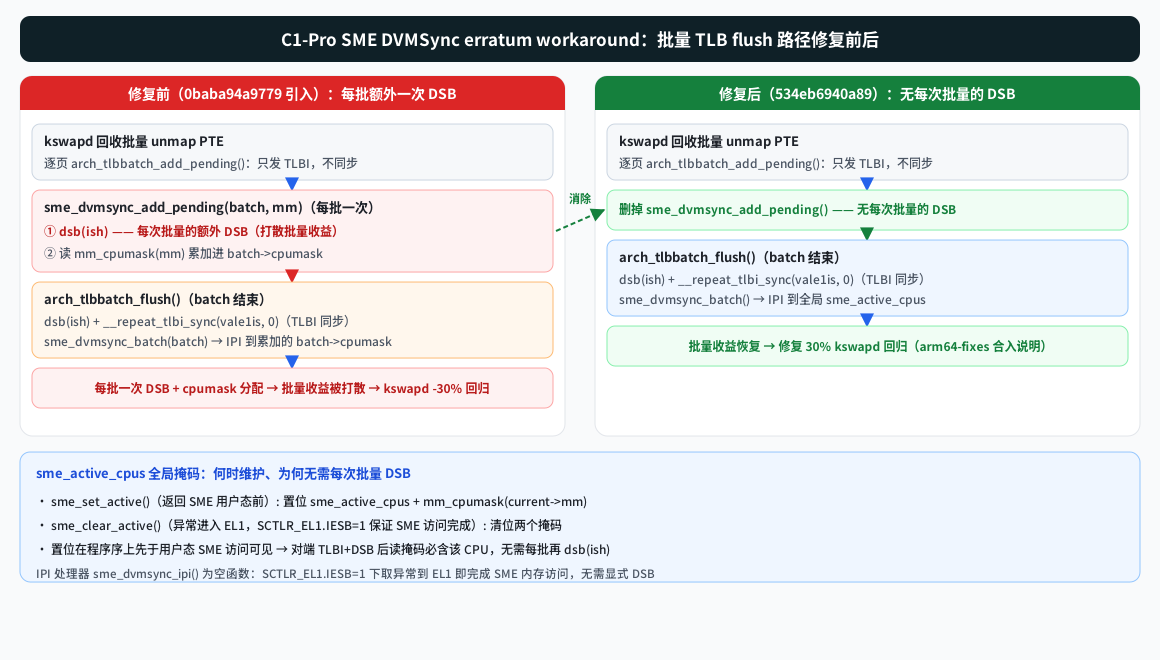
dsb(ish)(打散批量收益),修复后批量结束统一对全局 sme_active_cpus 发 IPI、无每批 DSB来源:基于本地内核 git(commit 534eb6940a89 + 被修 commit 0baba94a9779)真实 diff 绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 1 | kswapd 批量 unmap PTE,逐页 arch_tlbbatch_add_pending():只发 TLBI、不同步 | 批量累积,省掉每页 TLBI;DSB 的 DSB 等待 |
| 2 | (修复前)sme_dvmsync_add_pending():dsb(ish) + 读 mm_cpumask 累加进 batch cpumask | 保证 mask 读在硬件 DVMSync 之后 —— 但每批一次 DSB ← 被移除 |
| 3 | (修复后)删除该记账:无每批 DSB、无 per-task cpumask 分配 | 恢复批量收益(-87 行:含 arch_dup/release_tlbbatch_mask 生命周期代码) |
| 4 | batch 结束 arch_tlbbatch_flush():dsb(ish) + __repeat_tlbi_sync(vale1is, 0) 完成 TLBI 同步;随后 sme_dvmsync_batch() 对 sme_active_cpus 发 IPI | 统一同步 + DVMSync workaround 打断(IPI 处理器为空函数,靠 IESB 完成 SME 访问) |
@@ arch/arm64/include/asm/tlbflush.h
-static inline void sme_dvmsync_add_pending(struct arch_tlbflush_unmap_batch *batch,
-					   struct mm_struct *mm)
+static inline void sme_dvmsync_batch(void)
 {
 	if (!alternative_has_cap_unlikely(ARM64_WORKAROUND_4193714))
 		return;

-	/*
-	 * Order the mm_cpumask() read after the hardware DVMSync.
-	 */
-	dsb(ish);
-	if (cpumask_empty(mm_cpumask(mm)))
-		return;
-
-	/*
-	 * Allocate the batch cpumask on first use. Fall back to an immediate
-	 * IPI for this mm in case of failure.
-	 */
-	if (!cpumask_available(batch->cpumask) &&
-	    !zalloc_cpumask_var(&batch->cpumask, GFP_ATOMIC)) {
-		sme_do_dvmsync(mm_cpumask(mm));
-		return;
-	}
-
-	cpumask_or(batch->cpumask, batch->cpumask, mm_cpumask(mm));
-}
-
-static inline void sme_dvmsync_batch(struct arch_tlbflush_unmap_batch *batch)
-{
-	if (!alternative_has_cap_unlikely(ARM64_WORKAROUND_4193714))
-		return;
-
-	if (!cpumask_available(batch->cpumask))
-		return;
-
-	sme_do_dvmsync(batch->cpumask);
-	cpumask_clear(batch->cpumask);
+	sme_do_dvmsync(&sme_active_cpus);
 }
▲ 这段改动是机制成立的关键:被删掉的 dsb(ish) 正是“每批一次”的屏障;被删掉的 zalloc_cpumask_var(GFP_ATOMIC) 是每任务首次使用时的原子分配(批量刷热路径上不可忽略)。sme_dvmsync_batch() 精简到只剩一次对全局 sme_active_cpus 的广播——因为该掩码由 sme_set_active() 在程序序中先于用户态 SME 访问更新(见下段),读取它无需再排序。
@@ arch/arm64/kernel/fpsimd.c
 static cpumask_t sme_dvmsync_cpus;
+cpumask_t sme_active_cpus;
 ...
 	cpumask_set_cpu(cpu, mm_cpumask(current->mm));
+	cpumask_set_cpu(cpu, &sme_active_cpus);
 	/*
 	 * A subsequent (post ERET) SME access may use a stale address
 	 * translation. On C1-Pro, a TLBI+DSB on a different CPU will wait for
-	 * the completion of cpumask_set_cpu() above as it appears in program
-	 * order before the SME access. The post-TLBI+DSB read of mm_cpumask()
-	 * will lead to the IPI being issued.
+	 * the completion of the cpumask_set_cpu() operations above as they
+	 * appear in program order before the SME access. The post-TLBI+DSB
+	 * read of mm_cpumask() or sme_active_cpus will lead to the IPI being
+	 * issued.
 	 *
 	 * https://lore.kernel.org/r/ablEXwhfKyJW1i7l@J2N7QTR9R3
 	 */
@@
 	cpumask_clear_cpu(cpu, mm_cpumask(current->mm));
+	cpumask_clear_cpu(cpu, &sme_active_cpus);
▲ 这段保证新掩码的正确性:sme_set_active() 在返回 SME 用户态(ERET)之前置位 sme_active_cpus,程序序保证该置位对其它 CPU“后做 TLBI+DSB 的读取”可见——因此批量路径读到的掩码必然包含真正需要打断的 CPU,无需再用每批 DSB 去排序。sme_clear_active() 在异常进入 EL1 时清位(此时 IESB=1 已保证 SME 访问完成)。注释同步更新,把两种读取都写进文档。
📈 性能影响
dsb(ish) 是一条全系统屏障:执行时要等待此前所有 outstanding 的存储/TLBI 完成,期间流水线被卡住。每批一次 DSB 直接从回收热路径上移除,属于纯 on-CPU 的指令/等待开销削减。次类:开销降低(消除冗余记账)——同时删掉每批一次的
mm_cpumask() 读取、每任务首次的 zalloc_cpumask_var(GFP_ATOMIC) 分配,以及 arch_dup/release_tlbbatch_mask 的任务复制/释放管理。这些都属于 Brendan Gregg on-CPU vs off-CPU 视角里的 on-CPU 开销(屏障等待 + 指令执行),不涉及 off-CPU 锁/I/O 等待。
arch_tlbbatch_add_pending/arch_tlbbatch_flush 批量刷 → kswapd/直接回收 unmap):① C1-Pro(带 erratum 4193714)上的内存回收负载受益最大:旧路径每批白付一次 DSB,回收批量越小、越频繁,DSB 占比越高——这正是 kswapd 的典型形态(回收线程批量不大、持续进行),与合入说明的 30% 回归方向一致。
② 即便无 SME 进程在跑也受益:旧路径的
dsb(ish) 不区分“此刻有没有 SME 活跃 CPU”,只要硬件是 C1-Pro 就每批执行;新路径批量结束统一 sme_dvmsync_batch(),若 sme_active_cpus 为空则 sme_do_dvmsync() 直接返回,连 IPI 都不发。③ 非 C1-Pro 硬件不受影响:
alternative_has_cap_unlikely 运行时检查保证在无勘误 CPU 上整条路径 no-op(零开销)。
本补丁自身未提供独立基准:commit message 只描述机制(移除了每批 DSB 以恢复批量收益),未给出带环境的 before/after 数据。
逻辑分析(解读(AI 分析)):修复收益近似等于“回收热路径上每批一次 DSB 屏障等待 × 回收批次频率”。在内存压力持续、回收批次频繁的负载上,该开销占 kswapd 时间相当比例(合入说明量化约 30%);在内存充足、回收稀发的负载上近乎无感。本报告不据此编造更细的百分比。
🔄 方案演进
本补丁是单版本回归修复(无 v1→v2 系列演进),但“erratum workaround → 性能回归 → 本修复”的脉络值得记录(基于本地内核 git 提交链,真实可查):
ARM64_ERRATUM_4193714 + sme_set_active()/sme_clear_active()(mm_cpumask 跟踪)+ sme_dvmsync_add_pending() 批量记账,解决 C1-Pro 提前确认 DVMSync 的问题。本补丁 534eb6940a89(2026-06-10):发现 workaround 的批量路径“每批一次 DSB”打散批量收益,引入全局
sme_active_cpus 掩码替代逐 mm 采样,删除批量记账与 per-task cpumask 生命周期管理(+17/-87 行)。合入:2026-07-10 经
arm64-fixes 标签合入主线(merge d96fcfe1b7f9,随 v7.2-rc3 发布),与同批的“unmap_hotplug TLB flush 优化”(ff4c5a0de1f2)一起进入 Linux 7.2。
Cc + 最终 Signed-off-by 承接,Google 的 Joshua Liu 提供 Tested-by——说明该修复经过维护者审核与 Google 实测。核心设计权衡是:用“全局超集掩码”换“每批 DSB 移除”——sme_active_cpus 会打断“运行任何 SME 进程的 CPU”(略宽于“被 unmap 的 mm 所在 CPU”),但在批量刷场景下只多打断 SME 活跃的少数 CPU,远小于每批一次全系统屏障的成本,是明显划算的取舍。数据源说明:本环境 lore MCP 查询持续超时不可用,未能回溯该 commit 对应的补丁系列邮件线程(v1/v2 演进与完整 review 讨论无法独立确认)。上述演进/讨论信息来自本地内核 git(commit message 的
Fixes: / Tested-by: / Signed-off-by 链 + git log 提交链 + arm64-fixes 合并请求摘要),是合入主线的权威记录。
⚠️ 风险与局限
alternative_has_cap_unlikely 运行时为假)整条 sme_dvmsync_batch() no-op,行为与修复前一致、零开销。② 收益在内存回收(批量刷)负载上体现;非回收负载该路径不被高频触发,收益接近 0。
③ 正确性前提:
sme_active_cpus 必须与“用户态 SME 访问”在程序序上正确排序(置位先于 ERET 后的 SME 访问)——这正是 sme_set_active() 注释固化的架构约定(引用 lore 链接 abLEXwhfKyJW1i7l),是这类 workaround 的一贯做法。
arch_dup_tlbbatch_mask/arch_release_tlbbatch_mask 是内部实现,无外部 ABI 影响。运维可观测性:回归修复后,回收热路径上的 DSB 屏障应显著减少(可用 perf 统计 barrier 相关事件或对比回收吞吐);若仍观察到回收变慢,可从 sme_active_cpus 是否异常偏大(IPI 广播面变宽)入手排查。
sme_dvmsync(mm) 仍用 mm_cpumask(mm)(更精确的逐 mm 打断)未改,行为不变。新增的 sme_active_cpus 是全局变量(非 static),供 tlbflush.h 内联函数引用,链接范围内一致,无跨模块耦合风险。对 KVM/虚拟化路径无直接改动。
Cc + 最终 Signed-off-by),Google 的 Joshua Liu 提供 Tested-by——说明修复经维护者审核并有外部实测背书;未发现公开 NACK。最值得留意的设计质疑(推测):用超集掩码放宽 IPI 目标面,是否会在“大量 CPU 同时跑 SME 进程”时放大 IPI 广播——但这只影响 SME 活跃 CPU 子集,且批量路径本就低频(batch 结束一次),风险可控。
🔗 交叉引用
Fixes: 的被修 commit,引入 C1-Pro DVMSync workaround 与批量记账Merge tag 'arm64-fixes'(d96fcfe1b7f9) — 合入请求摘要,含 “Fix 30% kswapd performance regression” 的 30% 数据出处
本补丁 534eb6940a89(git.kernel.org) — arm64: Avoid eager DVMSync reclaim batches with C1-Pro SME erratum
sme_active_cpus 注释引用的 lore 链接(Message-ID: abLEXwhfKyJW1i7l@J2N7QTR9R3) — C1-Pro DVMSync 早确认问题的原始技术说明(代码内注释引用;lore.kernel.org 对 curl 有 Anubis 反爬,浏览器可访问)
同目录相关报告:arm64/mm 优化 unmap_hotplug TLB flush(ff4c5a0de1f2) — 与本文同属 arm64 TLB 刷效率主题(修复型优化),且与本补丁同批合入 Linux 7.2
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。