arm64/mm:优化 unmap_hotplug TLB flush — 减少内存热插拔路径的 TLB 广播开销
💡 一句话总结
在内存热移除场景下,arm64 拆除 vmemmap 映射时每清掉一个 2MB/1GB 的块级映射项(block entry),此前被 commit 48478b9f7913 改成按块大小去刷 TLB;在不支持 TLB 范围无效化(FEAT_TLBIRANGE,ARMv8.4+)的 CPU 上,这个“大范围刷”会越过内核阈值、退化成对全部 CPU 的一次广播式全 TLB 刷(flush_tlb_all())。而一个块级映射项在页表/TLB 里本就只占一条条目,只需对块内任意一页做一次失效即可将其逐出——本补丁把 vmemmap 路径的块级 flush 从块大小(PMD_SIZE / PUD_SIZE)收窄回单页(PAGE_SIZE),在保留线性映射路径“批量刷”收益的同时,消除了非 range 支持 CPU 上的全 TLB 广播风暴。本补丁未提供基准(修复型优化);上下文数据:被修 commit 48478b9f7913 曾自报批量刷使 2GB 内存热移除的 unmap_hotplug_range() 耗时降 97%(作者自报、未独立验证)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能 / 回归修复)——主导为性能优化,同时修复 48478b9f7913 引入的 TLB 失效回归 |
| 状态 | 状态(Merged)· 合入版本:Linux 7.2(git describe --contains 显示首个含此 commit 的 tag 为 v7.2-rc3) |
| 当前版本 | 主线单版本(无公开 lore 补丁系列可回溯,见“方案演进”数据源说明)· 合入版链接 |
| 版本演进 | 首版,暂无演进(修复型 commit,直接合入主线;回溯未及多版本系列) |
| 作者机构 | Anshuman Khandual(Arm)<anshuman.khandual@arm.com> |
| 提交日期 | 2026-06-26(committed,v7.2-rc3 周期内合入) |
| 改动范围 | arch/arm64/mm/mmu.c,+9/-2 行,1 文件 |
| 核心函数 | unmap_hotplug_pmd_range() / unmap_hotplug_pud_range() / flush_tlb_kernel_range() |
| 原始链接 | git.kernel.org(规范 commit 链接) |
| Fixes / 报告 | Fixes: 48478b9f7913(batched TLB flush in unmap_hotplug_range)· Reported-by: Ben Hutchings · Closes: lore 报告帖 |
| Review / 合入 | Reviewed-by: David Hildenbrand (Arm) · Reviewed-by: Catalin Marinas(arm64 维护者)· Signed-off-by / 注释与 message 改写:Will Deacon(arm64 维护者) |
📊 速览卡片
特性等级依据:修复型优化、作者未给基准(提升幅度无法量化给高分);但落地零配置(纯内核改动、无特殊硬件要求)、回归风险低(回退到 48478b9f7913 之前的旧行为)、维护者已 Ack;局限是收益场景较窄(仅内存热移除路径 + 仅非 FEAT_TLBIRANGE 的 CPU 上收益显著)——综合 ★★★。
🎯 解决什么问题
unmap_hotplug_range() 在 2GB 内存热移除(KVM guest)中耗时降 97%(作者自报、未独立验证)。但 48478b9f7913 在改动
unmap_hotplug_pmd_range()/unmap_hotplug_pud_range() 的 free_mapped(vmemmap)分支时,把块级表项的 flush 区间从单页顺手改成了块大小(PMD_SIZE/PUD_SIZE)——commit message 自述这是 “inadvertently introduced redundant TLB invalidation”(无意中引入冗余 TLB 失效),在不支持 range 失效的 CPU 上退化成全 TLB 广播。问题由 Ben Hutchings 报告(Reported-by / Closes 链接),本补丁据此修复。
arch/arm64/mm/mmu.c 的 unmap_hotplug_pmd_range() / unmap_hotplug_pud_range():当 vmemmap 路径(free_mapped=true)清掉一个 pmd_leaf()/pud_leaf() 块级表项后,调用 flush_tlb_kernel_range(addr, addr + PMD_SIZE)。而 flush_tlb_kernel_range()(arch/arm64/include/asm/tlbflush.h)先算 pages = (end-start) >> PAGE_SHIFT,再交给 __flush_tlb_range_limit_excess() 判定是否“超限”:① 不支持 FEAT_TLBIRANGE 的 CPU:
pages >= MAX_DVM_OPS 就全刷,而 MAX_DVM_OPS = PTRS_PER_PTE = 512(4KB 页配置)——刷一个 2MB PMD 块 = 512 页,正好 >=,于是退化成 flush_tlb_all()(全 TLB 广播);刷 1GB PUD 块 = 262144 页,同样全刷。② 支持 FEAT_TLBIRANGE(ARMv8.4+)的 CPU:阈值是
pages > MAX_TLBI_RANGE_PAGES(约 209 万页),块大小刷不会触发全刷,但仍是 1 条 range op 对 1 条 block 条目的“超额”失效(失效区间远大于实际需要)。核心错位在于:一个块级表项在 TLB 里只占一条 block 条目,无论刷 1 页还是刷整个 2MB/1GB,能被逐出的都是那同一条 block 条目——刷块大小是“只为清除一条条目,却把整段地址区间的 TLB 条目全部无效化”,本质是过度失效(over-invalidation)。
memory hot remove(offline_pages() → memory_block_offline() → unmap_hotplug_range())拆除被移除内存的 vmemmap(struct page 数组的虚拟映射)与线性映射,逐层下降到最后一级。高频触发场景:数据中心/云主机的物理内存热下线(DIMM 维护、按 QoS 归还物理页)、KVM/虚拟机内存气球回收、以及 ARM64 服务器常见的“整颗 NUMA 节点内存下线”。一次多 GB 的移除,vmemmap 里要清掉几千到几十万个块级表项。
为什么该场景踩中系统缺陷:每次清一个 PMD 块项,在非 FEAT_TLBIRANGE 的 CPU 上就触发一次
flush_tlb_all()——这条指令会向所有核广播并强制它们:DSB 等待、无效化整个 TLB(内核+用户全部地址空间)、再 ISB 同步。核数越多,广播与同步的开销越大;逐块重复几千上万次,就变成一次“广播风暴”,让整机所有核的地址翻译缓存被反复清空、后续访问靠重新走页表填充,热移除期间全局性能明显抖动。
🧩 核心机制
一句话机制:清掉一个块级映射项后,把 TLB 失效区间从“块大小”(2MB/1GB)收窄到“一页”。因为块级映射项在 TLB 中只对应一条 block 条目,对块内任意一页做一次失效即可命中并逐出这条条目——“单页”既是充分的,也是最小的。
if (free_mapped) 分支——即 vmemmap 路径(内存要被释放,必须先失效 TLB 再 free)。PMD/PUD 块项各自从 addr + PMD_SIZE / addr + PUD_SIZE 改回 addr + PAGE_SIZE,注释明确写了设计理由:“Invalidating a block entry requires just a single overlapping TLB invalidation, so limit the range of the flush to a single page.”(逐出块项只需一次与其重叠的单页失效)。这不改变任何 TLB 正确性——因为块条目是 1 条,任何落在块范围内的 VA 都能命中它。② 与“批量刷”共存,不动线性映射路径:48478b9f7913 的批量刷只适用于线性映射(
!free_mapped,无页释放,可以推迟到末尾统一刷),那部分代码本补丁未触碰;vmemmap 路径因“边清边释放”必须逐项刷,本补丁只是把这项刷的量级从“超额”拉回“精确”。两类路径的 TLB 语义都保持正确。
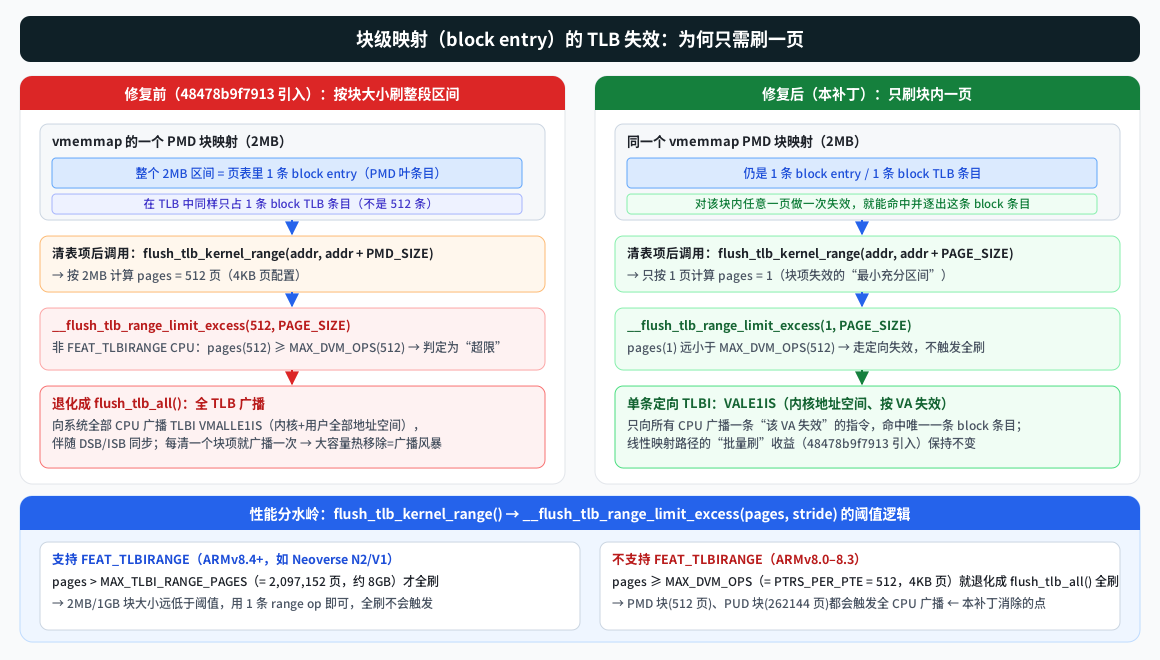
来源:基于本地内核 git(commit ff4c5a0de1f2)真实 diff + arch/arm64/include/asm/tlbflush.h 阈值逻辑绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 1 | pmd_clear(pmdp) / pud_clear(pudp) 清掉块级表项 | 从页表中移除 2MB/1GB 映射 |
| 2 | flush_tlb_kernel_range(addr, addr + PAGE_SIZE) | 只失效 1 页(=1 条 TLBI 指令),命中并逐出那条 block 条目 |
| 3 | (对比修复前)addr + PMD_SIZE/PUD_SIZE | 按 512/262144 页计算,非 range CPU 上触发 flush_tlb_all() 全广播 ← 被消除的冗余 |
| 4 | free_hotplug_page_range() 释放 vmemmap 页 | 失效完成后安全释放内存(vmemmap 路径语义不变) |
@@ unmap_hotplug_pmd_range()
 			if (free_mapped) {
 				/* CONT blocks are not supported in the vmemmap */
 				WARN_ON(pmd_cont(pmd));
-				flush_tlb_kernel_range(addr, addr + PMD_SIZE);
+				/*
+				 * Invalidating a block entry requires just
+				 * a single overlapping TLB invalidation,
+				 * so limit the range of the flush to a single
+				 * page.
+				 */
+				flush_tlb_kernel_range(addr, addr + PAGE_SIZE);
 				free_hotplug_page_range(pmd_page(pmd),
 							PMD_SIZE, altmap);
 			}

@@ unmap_hotplug_pud_range()
 		if (pud_leaf(pud)) {
 			pud_clear(pudp);
 			if (free_mapped) {
-				flush_tlb_kernel_range(addr, addr + PUD_SIZE);
+				/* See comment in unmap_hotplug_pmd_range(). */
+				flush_tlb_kernel_range(addr, addr + PAGE_SIZE);
 				free_hotplug_page_range(pud_page(pud),
 							PUD_SIZE, altmap);
 			}
▲ 这段改动是机制成立的关键:flush_tlb_kernel_range() 的失效成本由区间内页数决定——2MB 区间(512 页)在非 FEAT_TLBIRANGE 的 CPU 上正好撞上 pages >= MAX_DVM_OPS(512) 的全刷阈值,退化成全 TLB 广播;而 1 页区间永远走单条定向 VALE1IS。因为块项是单条 block 条目,1 页失效的 TLB 正确性与 2MB 失效完全等价,这就是“只刷一页”成立的依据。PMD 与 PUD 两处对称修改,注释(Will Deacon 改写)把这条架构知识固化下来,避免后人再次踩坑。
📈 性能影响
flush_tlb_all() 是向全部 CPU 广播的全 TLB 失效(TLBI VMALLE1IS + DSB/ISB 同步),每个核在广播到达时都要暂停执行、清空整 TLB、等同步完成;而单页失效只是一条按 VA 的 VALE1IS,广播成本低一个量级且无需全表清空。按 Brendan Gregg 的 on-CPU vs off-CPU 视角,本补丁削减的是“内存热移除时各核的等待/同步时间”,属于 off-CPU 广播开销的减少。次类:开销降低(消除冗余工作)——把“逐块全表广播”降为“逐块单条定向失效”,消除的是 48478b9f7913 顺带引入的过度失效(over-invalidation)冗余。
flush_tlb_kernel_range 阈值逻辑 → vmemmap 块项逐项刷 → 内存热移除):① 非 FEAT_TLBIRANGE 的 ARM64 CPU 收益最大(ARMv8.0–8.3,如 Cortex-A72/A53、部分较老服务器核):修复前每清一个块项就全 TLB 广播一次,修复后降为单条定向失效,广播次数从“逐块一次”归零。
② 核数越多、移除容量越大,收益越显著:全 TLB 广播的成本随核数近似线性增长(要同步的核更多),且热移除容量越大、块项越多,重复次数越多。
③ 支持 FEAT_TLBIRANGE 的 CPU 收益有限:这类 CPU 上块大小刷本来也走 range op,不触发全刷;修复主要是减少 TLBI 操作数(1 条 range op vs 1 条单页 op)与失效区间,幅度较小。
内存热移除是管理员低频操作而非常驻热路径,因此本补丁的收益是“操作发生时避免全局抖动”,不是常驻吞吐提升。
上下文数据(与本补丁同属 unmap_hotplug_range 优化、非本补丁自身):被修 commit 48478b9f7913 自报 “The time spent executing unmap_hotplug_range() improved 97% measured over a 2GB memory hot removal in KVM guest”(作者自报、未独立验证)——那是线性映射批量刷的收益,本补丁在此基础上修复 vmemmap 路径的回归,但作者未单独量化。
逻辑分析(解读(AI 分析)):修复把每个块项的失效从“全 CPU 全 TLB 广播”(广播 + 全表清空 + 同步,成本随核数增长)降为“单条定向 VA 失效”,单次成本相差可达数量级;但整体收益需乘以热移除容量中的块项数量与系统核数,本报告不编造具体百分比。
🔄 方案演进
本补丁是单版本回归修复(无 v1→v2 系列演进),但其“成因 → 报告 → 修复”的脉络值得记录(基于本地内核 git 提交链,真实可查):
unmap_hotplug_*_range(),当时块级表项清掉后即做单页失效(“One TLBI should be sufficient here as the PMD_SIZE range is mapped with a single block entry.”)——本补丁修复回退到的正是这个旧行为。48478b9f7913(2026-03-09,batched TLB flush):为修 CONT 块架构约束 + 提速,把线性映射路径改为批量刷;但在 vmemmap(
free_mapped)分支误将块项失效区间从单页放大到块大小,引入回归。Ben Hutchings 报告(lore 报告帖,
Closes 链接):指出该回归。ff4c5a0de1f2(本补丁,2026-06-26):vmemmap 块项失效区间收窄回单页,附扩大注释;经 Catalin Marinas、David Hildenbrand 审核,Will Deacon 改写注释与 commit message 后合入
v7.2-rc3。
[will: Reword comments and commit message] 承接最终改写,说明 arm64 维护者在 review 中把“为什么只需一页”的架构理由固化成了注释(“require just a single overlapping TLB invalidation”),避免后人再犯“按块大小刷”的错误。数据源说明:本环境 lore MCP 查询超时不可用,未能回溯该 commit 对应的补丁系列邮件线程(v1/v2 演进与完整 review 讨论无法独立确认)。上述演进/讨论信息来自本地内核 git(commit message 的
Fixes: / Reported-by: / Closes: / Reviewed-by / Signed-off-by 链 + git log 提交链),是合入主线的权威记录。
⚠️ 风险与局限
② 仅内存热移除路径受益;常驻负载(无热移除操作)行为不变(no-op)。
③ 正确性前提:单页失效能逐出整条 block 条目,依赖“block 条目是 1 条、对块内任意 VA 命中”的 arm64 架构事实——这正是注释里固化的假设,对标准 block 映射恒成立。
arch/arm64/mm/mmu.c 两处常量),无 Kconfig 开关、无 sysctl、无默认值/迁移路径问题,随主线 7.2 发布即可用。行为回退到 48478b9f7913 之前的旧行为,对依赖“块级表项失效后立刻可释放 vmemmap 页”的组件完全兼容。运维可观测性:热移除期间若仍有全 TLB 广播,可从 perf stat 的 TLB/tlb 事件或 DVM 同步开销察觉;修复后应观察到逐块广播消失。
vmem_altmap(设备内存的备用映射)路径共用 free_hotplug_page_range(),语义不变。
Reviewed-by,Will Deacon(arm64 维护者)改写注释与 message——说明经维护者审核通过。未发现公开 NACK;修复方向(回退到旧行为)明确且低风险。
🔗 交叉引用
arm64/mm: Enable memory hot remove(bbd6ec605c0f) — 内存热移除路径的引入者,原始单页失效行为所在
Ben Hutchings 报告帖(lore,本补丁 Closes 链接) — 回归的独立报告来源
本补丁 ff4c5a0de1f2(git.kernel.org) — arm64/mm: Optimize TLB flush in unmap_hotplug_[pmd|pud]_range()
内核 cachetlb 文档(Documentation/core-api/cachetlb.rst) — flush_tlb_all / flush_tlb_kernel_range 语义与 TLB 失效 API 约定
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。