sched/fair: Prefer fully idle cores for NOHZ balancing(v4 进展更新)
💡 一句话总结
在 SMT 超线程服务器上,NOHZ idle load balancer(负责替空闲 CPU 做均衡的 ILB)旧选核逻辑会去唤醒一个忙碌 core 的空闲 sibling,在 NVIDIA Vera(Olympus 核)上把正在计算的那个 sibling 的算力持续拉低;本补丁让 find_new_ilb() 优先选择整个 core 完全空闲的 CPU 作 ILB、以第一个空闲 CPU 兜底,遇到 busy core 就批量跳过其 siblings,从而保护 busy core 的算力——GEMM 基准实测吞吐 6.2 → 9.4 TFLOP/s(+50%)。v4 是第四版(v1→v2→v3→v4):按 AMD Prateek Nayak 与 Linaro Vincent Guittot 的意见移除冗余的 this_cpu 检查,并新获 IBM Mete Durlu 的 Reviewed-by(性能数据为作者自报,未独立验证,与 v3 相同)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(performance)——ILB 选核路径的 SMT 感知裁剪 |
| 状态 | In Review(v4,NVIDIA 提出) |
| 当前版本 | v4 · lore 链接 |
| 版本演进 | v1(07-28)→ v2(07-29)→ v3(07-31)→ v4(08-04,+44/-11,移除冗余 this_cpu 检查 + 新获 Mete Durlu Reviewed-by) |
| 作者机构 | Andrea Righi(NVIDIA) |
| 提交日期 | 2026-08-04(v4) |
| 改动范围 | kernel/sched/fair.c,+44/-11 行,1 文件(单补丁,非 patchset) |
| 核心函数 | find_new_ilb() / kick_ilb() |
| 评审标签 | Reviewed-by: Mete Durlu(IBM,v4 新增) |
| 原始链接 | lore Message-ID |
📊 速览卡片
🎯 解决什么问题
find_new_ilb() 只挑第一个空闲的 housekeeping CPU,不看它所在的物理 core 是否完全空闲。NVIDIA 在 Vera 平台(Olympus 核)上观测到:短暂唤醒一个忙碌 core 的空闲 sibling,会把该 core 上另一个 sibling 的单线程性能拉低,且干扰不会随被唤醒 sibling 进入 WFI 立即结束——需要 sibling 空闲满 10 Ki cycles(约 1 万周期)才恢复满血;反复的短唤醒即使几乎没有真正重叠也会维持干扰。
find_new_ilb() 在 nohz.idle_cpus_mask ∩ housekeeping 里按 CPU 顺序取第一个 idle_cpu()。它不区分「该 CPU 空闲」与「该 CPU 所在 core 完全空闲」——两者在 SMT 系统上是不同的。若选中的 ILB 恰是忙碌 core 的空闲 sibling,激活它做均衡就会抢占共享执行资源,干扰正在跑计算的那个 sibling。
🧩 核心机制
v4 把 find_new_ilb() 重写为「优先完全空闲 core,fallback 兜底」的选核器:在候选集合上逐 CPU 考察,只对真正空闲的 CPU 再问一句「你的 core 是否完全空闲」;是则立即选中,否则把它记为首个 fallback 并批量跳过其 SMT siblings,避免对已知不满足条件的 core 做逐 CPU 重复检查。
kernel/sched/fair.c 的 find_new_ilb(),是 NOHZ 均衡的「选人」环节,不碰均衡算法本身。核心变化有三:
- 候选集合本地化:把原来
for_each_cpu_and(...)的「按顺序取第一个」改成先cpumask_and出一份本地ilb_cpus,复用每-CPU 的select_rq_mask(关中断保护,无需额外锁)。 - 两级判定:
idle_cpu()判断「该 CPU 空闲」(可做均衡的最小前提),is_core_idle()判断「整个 core 空闲」(无干扰的最优前提)。前者是既有条件,后者是 v2 引入、v4 保留的 SMT 感知条件。 - 批量剪枝:无论遇到 busy CPU 还是「空闲但 core 不空闲」的 CPU,都用
cpumask_andnot(ilb_cpus, cpu_smt_mask(ilb_cpu))一次性跳过该 core 的其余 siblings——这是 v2(Prateek 建议)与 v3(Mete 建议)逐步完善的剪枝,v4 保留。
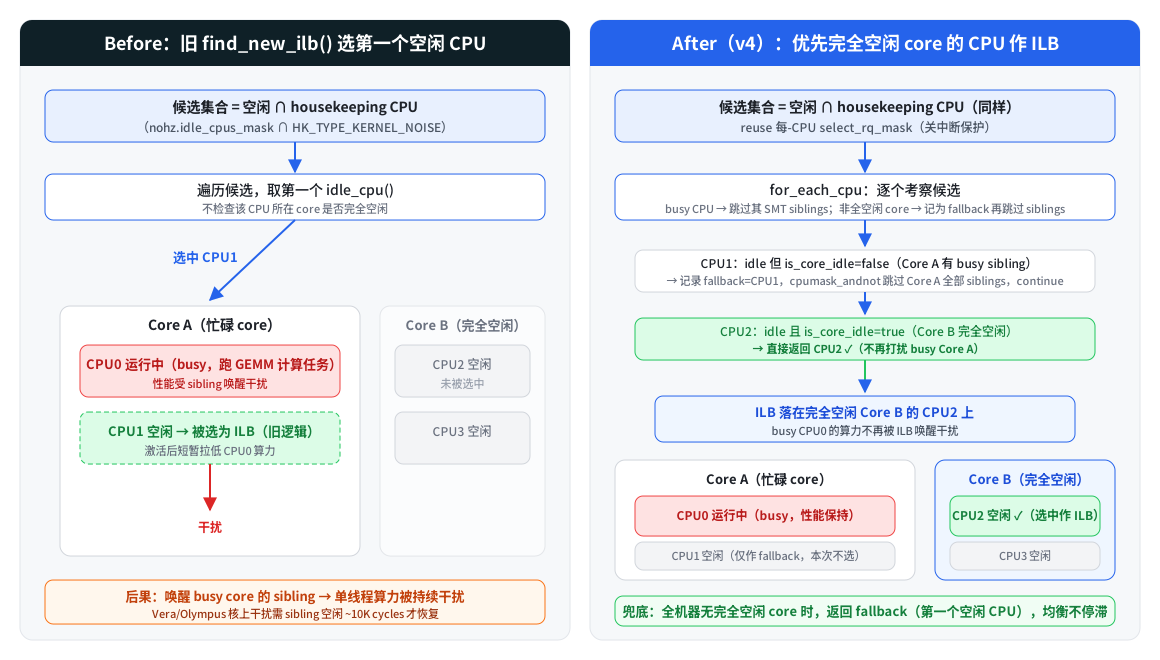
来源:基于 lore 真实补丁 diff(v4)绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 构建候选 | cpumask_and(ilb_cpus, nohz.idle_cpus_mask, housekeeping_cpumask(HK_TYPE_KERNEL_NOISE)) | 本地化「空闲且 housekeeping」的候选集合,复用每-CPU mask 免锁 |
| busy CPU 剪枝 | 非空闲且已有 fallback → cpumask_andnot(ilb_cpus, cpu_smt_mask) | busy 证明该 core 不可能全空闲,跳过其 siblings,减少无效遍历 |
| core 空闲判定 | 空闲但 !is_core_idle() → 记 fallback,跳过 siblings,continue | 非全空闲 core 的 CPU 只作兜底,优先找全空闲 core |
| 返回 | 全空闲 core 的 CPU 立即返回;循环结束返回 fallback 或 -1 | 优先全空闲 + 兜底保证均衡推进 |
 static inline int find_new_ilb(void)
 {
-	int this_cpu = smp_processor_id();
-	const struct cpumask *hk_mask;
-	int ilb_cpu;
+	struct cpumask *ilb_cpus;
+	int ilb_cpu, fallback = -1;
+
+	lockdep_assert_irqs_disabled();
+
+	/*
+	 * Reuse the per-CPU select_rq_mask, which is protected from concurrent
+	 * use on this CPU by having interrupts disabled.
+	 */
+	ilb_cpus = this_cpu_cpumask_var_ptr(select_rq_mask);
+	cpumask_and(ilb_cpus, nohz.idle_cpus_mask,
+		    housekeeping_cpumask(HK_TYPE_KERNEL_NOISE));
+
+	for_each_cpu(ilb_cpu, ilb_cpus) {
+		if (!idle_cpu(ilb_cpu)) {
+			/*
+			 * Once an idle fallback exists, a busy CPU proves that
+			 * this core cannot be fully idle. Skip its siblings.
+			 */
+			if (sched_smt_active() && fallback >= 0)
+				cpumask_andnot(ilb_cpus, ilb_cpus, cpu_smt_mask(ilb_cpu));
+			continue;
+		}

-	hk_mask = housekeeping_cpumask(HK_TYPE_KERNEL_NOISE);
+		/*
+		 * Running the idle load balancer on an idle sibling of a busy
+		 * SMT core can reduce the capacity available to its sibling. Prefer
+		 * a CPU whose entire core is idle, but retain the first idle CPU as
+		 * a fallback so idle balancing can still make progress when no fully
+		 * idle core exists.
+		 */
+		if (sched_smt_active() && !is_core_idle(ilb_cpu)) {
+			if (fallback < 0)
+				fallback = ilb_cpu;

-	for_each_cpu_and(ilb_cpu, nohz.idle_cpus_mask, hk_mask) {
-		if (ilb_cpu == this_cpu)
+			/*
+			 * The core is not idle, so there is no need to check
+			 * any of its other SMT siblings.
+			 */
+			cpumask_andnot(ilb_cpus, ilb_cpus,
+				       cpu_smt_mask(ilb_cpu));
 			continue;
+		}

-		if (idle_cpu(ilb_cpu))
-			return ilb_cpu;
+		return ilb_cpu;
 	}

-	return -1;
+	return fallback;
 }
▲ 为什么这是最核心的:fallback = -1 与 is_core_idle() 分支是「优先全空闲 + 兜底」的全部逻辑,cpumask_andnot(cpu_smt_mask) 是「遇到已知 busy/非全空闲 core 就批量跳过」的剪枝核心;v4 相对 v3 的主要变化是删掉了被 Prateek/Vincent 指为冗余的 this_cpu 变量与 if (ilb_cpu == this_cpu) continue; 分支(find_new_ilb() 的调用方必然不在 nohz.idle_cpus_mask 中,该分支恒不命中,解读(AI 分析))。(其余 diff 读者可自查 lore)
📈 性能影响
find_new_ilb(),它在系统有多个 NOHZ 空闲 CPU、需要定期触发均衡时被高频调用。收益最大的配置是:SMT 超线程已启用 + 每个 core 上各跑一个 CPU 密集任务(ILB 候选多为忙碌 core 的 sibling)+ sibling 唤醒恢复慢的核(NVIDIA Olympus/Vera)。在这些前提下,ILB 每次选核都避开忙碌 core,busy sibling 不被周期性唤醒,GEMM 这类单核峰值敏感负载的吞吐得以完整释放。
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| GEMM 通用矩阵乘法(HPC/深度学习核心算子,CPU 密集,一个 SMT core 一个计算任务) | NVIDIA Vera 平台(Olympus 核),SMT 启用 | ~6.2 TFLOP/s | ~9.4 TFLOP/s(+50%) |
说明:数据来自 v4 补丁说明原文(作者用 ad hoc GEMM 基准、在 CPU affinity 掩码内每个 SMT core 跑一个 CPU 密集任务测得)。作者自报,未独立验证,且与 v3 报告的数据完全相同(v4 未新增基准)。补丁未提供更广的多负载/多平台数据;非 SMT 平台补丁明确声明行为不变(继续选第一个空闲 housekeeping CPU)。
来源:作者自报数据 + 基于 lore v4 diff 绘制
🔄 方案演进
单补丁,v1 → v4 四次迭代,每次都由 review 讨论推动(基于 lore 各版本 changelog 与讨论,不编造):
v2(07-29,+39/-9):Prateek Nayak(AMD)建议——引入
is_core_idle() 判定,并在宽 SMT 系统上通过剪掉「部分忙碌 core 的其余 siblings」避免重复 core-idle 检查。v3(07-31,+47/-9):Mete Durlu(IBM)建议——找到 idle fallback 后,一旦遇到 busy CPU 就跳过其全部 siblings,避免对已知忙碌 core 做逐 CPU 遍历。
v4(08-04,+44/-11):Prateek Nayak + Vincent Guittot(Linaro)意见——移除冗余的
this_cpu 检查;并新获 Mete Durlu Reviewed-by。
- v1 讨论:AMD Prateek Nayak(message-id)质疑仅按「完全空闲 core」裁剪是否覆盖所有调用路径;Peter Zijlstra(message-id)质疑
idle_cpu()判断 sibling 影响不够严谨——推动 v2 引入is_core_idle()。 - v3 → v4:Vincent Guittot 回复 v3(message-id)与 Prateek 共同指出
this_cpu检查冗余,v4 将其删除(删除后功能不变,见核心机制)。 - Mete Durlu:v3 时提出剪枝改进(见演进脉络),v4 补上 Reviewed-by(回复 v3 的消息:message-id)。
- v4 发布后:IBM Shrikanth Hegde 在 v4 发布后数分钟有跟进回复(message-id),讨论仍在继续。
注:v1/v2/v3 的版本规模(+N/-N)取自对应版本 lore 消息的 patch_stats,供横向对比演进幅度。
⚠️ 风险与局限
sched_smt_active() 的超线程平台上成立;非 SMT 平台 sched_smt_active() 为假,行为与旧版完全一致(no-op 路径,选第一个空闲 housekeeping CPU)。即使在 SMT 平台上,作者也说明大多数平台 ILB 的瞬时 sibling 唤醒影响可忽略——GEMM +50% 是 NVIDIA Olympus 核「唤醒后需 ~10Ki cycles 恢复」这一特性的产物,不能直接外推到所有 SMT 平台。
- 可能的唤醒延迟 / 能耗代价:作者在 v4 说明中明确指出——偏好可能去唤醒一个完全空闲的物理 core,而非用忙碌 core 的空闲 sibling,这在某些架构上可能增加 ILB 唤醒延迟或能耗(空闲 core 需从深 idle 状态唤醒)。
- 扫描更多 CPU:为找完全空闲 core 可能多看几个候选(正是 v2/v3 的批量跳过在压低这个代价),极端情况下选核路径变长。
- 兜底不失效:全机器无完全空闲 core 时返回 fallback(第一个空闲 CPU),均衡推进不会停滞——这是防退化设计。
kernel/sched/fair.c 内部,不新增 sysctl/计数器,不改用户态 ABI;复用每-CPU select_rq_mask(依赖关中断保护),对其它子系统无接口影响。唯一需要关注的是与 nohz_full / isolcpus 组合时的行为(housekeeping 集合内选择),本补丁未改变「只在 housekeeping CPU 里选 ILB」的既有约束。
- 已解决:Prateek 的调用路径覆盖质疑(→ v2 is_core_idle)、Peter 的 sibling 语义质疑(→ v2)、Mete 的逐 CPU 遍历浪费(→ v3 批量跳过)、Prateek/Vincent 的 this_cpu 冗余(→ v4 删除)。
- 遗留观察点:v4 发布后 Shrikanth Hegde 有跟进回复(message-id),是否提出新质疑尚未见作者回应(解读(AI 分析),消息正文未能从归档取回,仅记录其存在)。
🔗 交叉引用
SMT-aware asymmetric CPU capacity (v5) — 同一作者(NVIDIA)的姊妹系列,解决 SMT 算力高估问题,与本补丁同属「调度器感知 SMT 拓扑」方向
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。