sched/fair: Prefer fully idle cores for NOHZ balancing
CFS 调度器 · NOHZ idle load balancer · SMT 感知优化
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(performance)——选核路径的 SMT 感知裁剪 |
| 状态 | In Review(v3,NVIDIA 提出) |
| 当前版本 | v3 · lore 链接 |
| 版本演进 | v1(07-28,+18/-5)→ v2(07-29,+39/-9,响应 AMD Prateek 质疑)→ v3(07-31,+47/-9,处理 Peter Zijlstra 讨论) |
| 作者机构 | Andrea Righi (NVIDIA) |
| 提交日期 | 2026-07-31(v3) |
| 改动范围 | kernel/sched/fair.c,+47/-9 行,1 文件 |
| 核心函数 | find_new_ilb() / kick_ilb() |
| 原始链接 | lore Message-ID |
💡 一句话总结
在 SMT 超线程服务器场景下,通过让 find_new_ilb() 优先选择整个 core 完全空闲的 CPU 作为 NOHZ idle load balancer,避免激活 busy core 的 SMT sibling 而拉低其算力,在 NVIDIA Vera 平台的 GEMM 基准中实测吞吐提升约 50%(6.2 → 9.4 TFLOP/s)。
📊 速览卡片
核心机制
SMT 感知选核
优化目标
保护 sibling 算力
适用场景
超线程服务器
实测提升
GEMM +50%
🎯 解决什么问题
系统层面:ILB 选择未感知 SMT 拓扑
NOHZ idle load balancing 需要选一个空闲 CPU 当 ILB,代表空闲 CPU 做均衡。
原
find_new_ilb() 只挑第一个空闲 housekeeping CPU,不看它所在 core 是否完全空闲。
场景层面:SMT sibling 唤醒干扰 busy core
若 ILB CPU 是繁忙 core 的 sibling,激活它会降低 busy sibling 性能。
NVIDIA 观测到:短暂唤醒后单线程性能需 sibling 空闲 ~10,000 cycles 才恢复。
受影响负载:GEMM 等计算密集型 HPC、超线程服务器延迟敏感应用
🧩 核心机制
重写 find_new_ilb(),在候选集合层面做 SMT 感知裁剪:
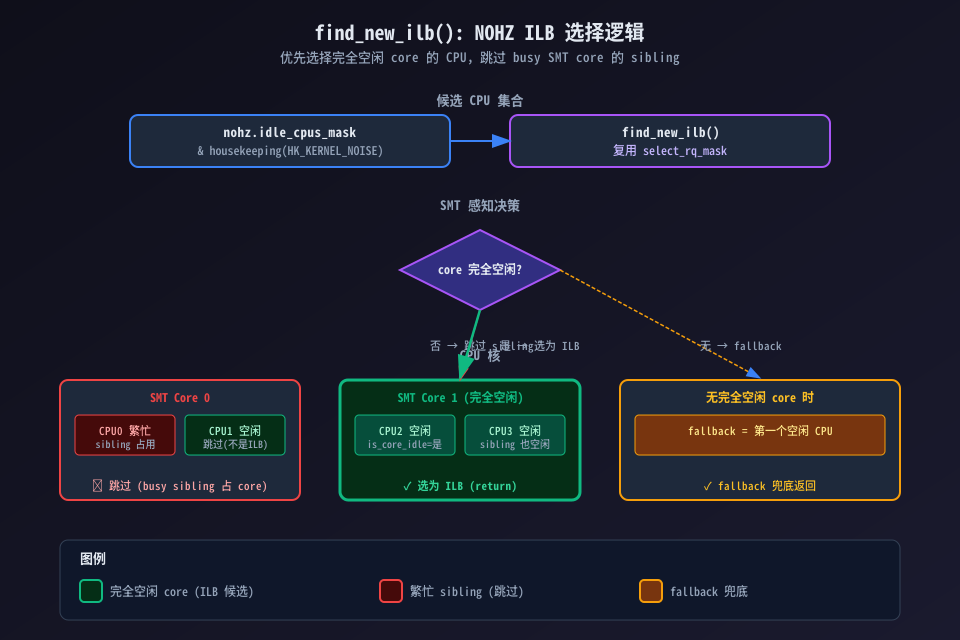
来源:基于 lore 真实补丁 diff 绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 构建候选 | cpumask_and(idle, nohz.idle_cpus_mask, housekeeping) | 空闲且 housekeeping 的 CPU |
| SMT 裁剪 | busy CPU 或非全空闲 core → cpumask_andnot(cpu_smt_mask) | 跳过有 busy sibling 的 core |
| 返回 | 全空闲 core 的 CPU;无则 fallback | 优先 + 兜底 |
🔬 关键代码
+	if (!idle_cpu(ilb_cpu)) {
+		/* 有 busy sibling 的 core 不可用,跳过其 SMT mask */
+		if (sched_smt_active() && fallback >= 0)
+			cpumask_andnot(ilb_cpus, ilb_cpus,
+				       cpu_smt_mask(ilb_cpu));
+		continue;
+	}
+	/* 优先选整个 core 都空闲的 CPU,保留第一个空闲作 fallback */
+	if (sched_smt_active() && !is_core_idle(ilb_cpu)) {
+		if (fallback < 0)
+			fallback = ilb_cpu;
+		cpumask_andnot(ilb_cpus, ilb_cpus,
+			       cpu_smt_mask(ilb_cpu));
+		continue;
+	}
▲ 核心:遇到 busy/非全空闲 core 批量跳过其 sibling;保留 fallback 兜底
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| GEMM 通用矩阵乘法(HPC/深度学习核心算子,计算密集型负载) | NVIDIA Vera 平台,SMT 超线程启用 | ~6.2 TFLOP/s | ~9.4 TFLOP/s(+50%) |
说明:GEMM 是矩阵乘法基准,代表 HPC/深度学习场景的计算密集型负载,对单核算力敏感,因此保护 sibling 算力能带来显著收益。补丁 commit message 未提供基准,此实测数据来自补丁讨论/关联工作(解读(AI 分析):数据出处为 NVIDIA 在讨论/关联工作中自报,未独立验证)。
💬 讨论焦点
v1 讨论:AMD Prateek 与 IBM 的质疑推动 v2 重构
- AMD K Prateek Nayak(07-29)对 v1 提出疑问:仅按「是否完全空闲 core」裁剪候选,是否覆盖了
find_new_ilb()的所有调用路径?ibm.com 的 Swapnil Shegde 也加入讨论。 - Peter Zijlstra(07-29)质疑 SMT 检测逻辑的语义:用
idle_cpu()判断 sibling 是否影响 busy core 不够严谨,应区分「core 是否完全空闲」与「仅该 CPU 空闲」。
v2 → v3:按 review 完善 SMT 检测
v2(+39/-9)响应 AMD/IBM 质疑,扩大改动面并引入
is_core_idle() 判定;v3(+47/-9)进一步处理 Peter 的关切:对 busy core 的 sibling 批量跳过(cpumask_andnot(cpu_smt_mask)),保留 fallback 兜底。IBM meted@linux.ibm.com(07-31)在 v3 发布后继续参与讨论。
⚠️ 风险与局限
潜在回归 / 并发 / 边界
- 多核扩展性:SMT 裁剪引入的
cpumask_andnot只在sched_smt_active()时生效;非 SMT 平台上行为与旧版一致(no-op 路径)(解读(AI 分析))。 - 均衡延迟:若整个机器都无完全空闲 core,ILB 选择会退化到 fallback——但这只是「选核偏好」而非「不均衡」,均衡不会被卡死(补丁保留 fallback 逻辑)。
- 架构相关:收益依赖 SMT 拓扑下 sibling 唤醒对 busy core 的干扰程度;不同 SMT 布局(如 POWER 与 x86)干扰成本不同,GEMM +50% 是 NVIDIA Vera 平台数据,未必全平台适用(讨论中已有人质疑该收益的可移植性,解读(AI 分析))。
- 补丁未提供:commit message 未给出更广泛的基准(多负载/多平台),仅 GEMM 单点数据。
严重度:MINOR(选核偏好优化,非正确性改动;主要风险在收益的可移植性)· review 质疑:AMD/IBM/Peter Z 均有参与,已在 v2/v3 响应
🔗 交叉引用
📌 关联工作
SMT-aware asymmetric CPU capacity (v5) — 同一作者的姊妹系列,解决 SMT 算力高估问题
NOHZ ILB fallback 选项(Adam Li / Valentin Schneider 讨论) — nohz_full 场景的同类优化
NOHZ ILB fallback 选项(Adam Li / Valentin Schneider 讨论) — nohz_full 场景的同类优化
✅ 关键洞察
- 发现:优先选完全空闲 core 的 CPU 作 NOHZ ILB(跳过 busy core 的 SMT sibling),解决「唤醒 sibling 拉低 busy core 算力」的选核缺陷。
- 证据:NVIDIA Vera 上实测 GEMM +50%(6.2 → 9.4 TFLOP/s,作者自报,未独立验证);对 HPC/延迟敏感负载意义大。
- 边界:仅在
sched_smt_active()的超线程平台生效;非 SMT / 无空闲 core 时回退旧行为(fallback 兜底,均衡不停滞)。 - 风险 / 建议:单平台单负载数据,收益可移植性待验证;v1→v3 经 AMD/IBM/Peter Zijlstra 多轮 review 完善,属选核偏好优化而非正确性修复。
⚠️ 免责声明
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。