mm/mglru: frequency guided promotion (MGLRU-FG)
💡 一句话总结
在内存受限(memcg 限额 + 磁盘/ZRAM swap)的混合访问负载下,主线上游 MGLRU 对页面缓存只有"最近是否被引用"这一单比特热度信息:热顺序读(readahead 进入时 refs==0)被误判为冷页优先回收,冷随机扫描又反复污染缓存——作者复现 SQLite 热顺序+小热区场景从经典 LRU 的 14.51ms 恶化到主线上游 MGLRU 的 567.05ms(约 39 倍)。本系列(MGLRU-FG,腾讯 Kairui Song,RFC v2 共 15 补丁)把热度判断从"单比特引用"升级为统一的 0~7 访问计数(refs),按访问频率分档(tier),并在热度达标时把 folio 惰性提升到更年轻代际(gen climbing),让缓存保护按访问频率而非仅按最近访问来分配。作者自报(未独立验证):Chromium & Node.js 测试总请求数 +47.4%、MongoDB YCSB +10.3%、FIO zipf +11.1%、内核构建 refault_file -32%。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(页面回收/工作集跟踪,性能)+ 重构(统一 LRU flag 语义、减少 MGLRU flag 占用) |
| 状态 | In Review(RFC,未合入主线) |
| 当前版本 | v2 · cover letter(15 补丁) |
| 版本演进 | v1(2026-05-01,32 补丁,"MGLRU-FG and refault distance support")→ v2(2026-08-03,15 补丁,砍掉 refault distance,聚焦 MGLRU-FG + flag cleanup) |
| 版本标签 | 目标 Linux 7.3(RFC 未合入主线,非已确定版本;tag 为 7.3 周期候选标注) |
| 作者机构 | Kairui Song(腾讯 Tencent,kasong@tencent.com) |
| 提交日期 | 2026-08-03(v2 系列,实际 08-03/08-04 北京时间) |
| 改动范围 | v2:17 文件,+689/-349(15 补丁);核心补丁 09/15 6 文件 +385/-226 |
| 核心函数 | folio_inc_lru_refs() / lru_tier_from_refs() / lru_refs_from_flags() / folio_update_gen() / folio_inc_gen() / lru_gen_refault() |
| 原始链接 | lore Message-ID |
版本说明:作者内部把 08-03 这版按新 change-id 标为 "V1",但从社区视角它是 05-01 32 补丁 RFC 之后的第二次迭代,本文按 v1→v2 记述。
📊 速览卡片
特性等级依据:实测数据亮眼(Chromium/Node.js +47.4%、YCSB +10.3%,作者自报)且纯内核改动、不依赖特殊硬件、落地门槛低;但仍是 RFC 未合入,且 refault distance 未含入(对工作集剧变响应慢),tier 数固定 4 —— 收益需在内存压力场景才体现 → ★★★★
🎯 解决什么问题
lru_gen_refault();
② 主体(补丁 9/15)"frequency guided workingset promotion (MGLRU-FG)":实现按访问频率的计数/分档/代际提升;
③ 收尾(补丁 10-15):把 refs 计数做成通用 API 并接入 smaps、huge_memory、khugepaged、madvise 等。
系列还顺带统一了经典 LRU 与 MGLRU 的 flag 语义,把 MGLRU 的 flag 占用减少一位。
lru_gen_folio_seq() 把 refs==1 的新 folio 抬到"第二旧代"——意外让随机读更热、顺序读更冷:顺序读依赖 readahead,而 readahead folio 以 refs==0 进入最旧代,folio_mark_accessed() 对代际几乎无效;随机直读 folio 则从 refs==1 起步,天然被保护。作者认为这不是好的解:它依赖 LRU drain 时机,不可靠,且会伤害"顺序部分实际更热"的负载(如一个热的大文件 + 大量冷小文件)。MGLRU-FG 的目标是在不依赖这个"初始 bump"的前提下覆盖普通工作负载,且不伤害 scan-get 型负载。
PG_referenced 一个比特("最近是否被引用过")+ PG_workingset 标记,无法区分"访问 1 次"和"访问 7 次"。其后果:
① 热顺序读被误判——readahead 批量读入的页 refs==0,即使反复命中也被当作冷页;
② 冷随机扫描污染缓存——一次性读入的冷页与真正热的页挤在同一代;
③ PSI / smaps / readahead 精度差——workingset 判断不准确导致内存压力统计欠计;
④ flag 占用——MGLRU 在 folio flags 上用了 PG_referenced + PG_workingset + LRU_REFS_MASK 三块,压缩空间有限。
- memcg 限额的编译/批处理容器(如 3G 限额下 make -j48 + 磁盘 swap)——内核构建产生大量临时页缓存,缓存热度判断直接决定换入换出量;
- 数据库(MongoDB/YCSB,16G memcg)——B-tree 遍历既有顺序扫描又有随机点查,两种访问模式的热度特性完全不同;
- 桌面/浏览器 + Node.js 混合负载(ZRAM swap,48c96t 128G)——大量短生命周期页 + 少量热页;
- SQLite 热顺序 + grep 冷扫描——前者验证"热顺序部分能否被保护",后者验证"一次性冷页能否被快速回收不污染缓存"。
🧩 核心机制
MGLRU-FG 的核心思想一句话:把"热度"从单比特(referenced?)换成 0~7 的访问计数(refs),按计数分档保护,并在计数达到上限时把 folio 惰性搬到更年轻的代际。这样页面缓存的热部分会按"访问频率"自动向上爬,冷部分快速沉到最旧代被回收。
include/linux/mm_inline.h(refs 编解码)、include/linux/mmzone.h(tier 模型与常量)、mm/swap.c(访问路径 folio_inc_lru_refs)、mm/vmscan.c(回收/晋升路径 folio_update_gen / folio_inc_gen / sort_folio / get_tier_idx)、mm/workingset.c(refault 恢复 refs)。四个核心逻辑点:
- 统一 refs 计数:
lru_refs_from_flags()现在把PG_referenced(bit0)、PG_workingset(bit1)、LRU_REFS_MASK(高位移 2)一起拼成一个 0~7 的计数——不再把 workingset 当成一个独立的"最后一档"标记。 - 按频分档:
lru_tier_from_refs()从order_base_2(refs)改成fls(refs-1),访问 2 次即进入 workingset 档(tier1),访问 3+ 次进入更高 tier,形成"越热越靠后回收"的层次。 - 惰性代际提升(gen climbing):访问路径在 refs 达到
LRU_REFS_MAX时,通过"清 PG_lru 隔离 + RCU 读锁 +lru_gen_update_size()"把 folio 抬到gen+1,全程不拿 LRU 锁,只做一次原子 cmpxchg——这是"频率引导提升"的名字由来,也是性能关键。 - refault 恢复 refs:eviction 时把 refs 编码进 shadow(
pack_shadow),refault 时经lru_gen_refault()还原 refs 并参与 tier 统计,让被换出的热页回来时能"接续"其热度而非从 0 开始。
folio_mark_accessed() 会真实递增 refs,几次访问后 folio 就"爬"到更年轻代并被 tier 保护——缓存里留下的是真热页,换入换出和 refault 随之下降。
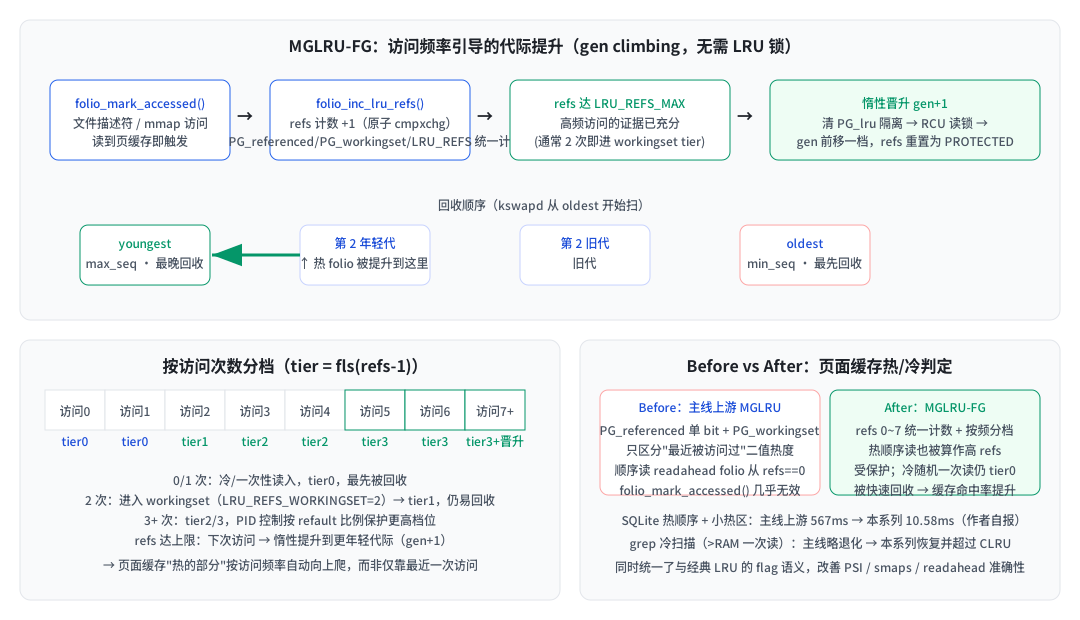
来源:基于 lore 真实补丁 diff(v1 06/32 / v2 09/15)绘制
| 步骤 | 关键代码 | 目的 |
|---|---|---|
| 访问计数 | folio_inc_lru_refs():refs +1(原子 cmpxchg) | 把"最近访问过"升级为"被访问了几次" |
| 分档 | lru_tier_from_refs() = fls(refs-1) | 2 次即进 workingset 档,越热 tier 越高越难回收 |
| 惰性晋升 | refs 达 LRU_REFS_MAX → 清 PG_lru + RCU → gen+1 | 热页按频率搬到更年轻代,无需 LRU 锁 |
| refault 还原 | lru_gen_refault():shadow 存/还原 refs | 换出的热页回来时热度不归零 |
static inline int lru_tier_from_refs(unsigned int refs)
 {
-	VM_WARN_ON_ONCE(refs > BIT(LRU_REFS_WIDTH));
-	/* see the comment on MAX_NR_TIERS */
-	return workingset ? MAX_NR_TIERS - 1 : order_base_2(refs);
+	VM_WARN_ON_ONCE(refs > LRU_REFS_MAX);
+	if (refs < LRU_REFS_WORKINGSET)
+		return 0;
+	return fls(refs - 1);
 }

 static inline int lru_refs_from_flags(unsigned long flags)
 {
-	if (!(flags & BIT(PG_referenced)))
-		return 0;
+	int refs;
 	/* Return the total number of accesses. Also see the comment on
 	 * LRU_REFS_FLAGS. */
-	return ((flags & LRU_REFS_MASK) >> LRU_REFS_PGOFF) + 1;
+	refs = (flags & BIT(PG_referenced)) ? BIT(0) : 0;
+	refs += (flags & BIT(PG_workingset)) ? BIT(1) : 0;
+	refs += ((flags & LRU_REFS_MASK) >> LRU_REFS_PGOFF) << 2;
+	return refs;
 }
▲ 这段是机制的地基:把 PG_referenced / PG_workingset / LRU_REFS_MASK 三个分散标记统一编成一个 0~7 的访问计数。旧代码里 workingset 是独立的"最后一档"布尔;新代码里它只是计数的 bit1——于是"访问 2 次"就能进 workingset 档,而"访问 7 次"的页与"访问 2 次"的页在热度上被明确拉开。这是"按频率而非按是否引用"的分水岭。
/* To promote frequently used folios, prevent isolation
 * first, it's a lazy promotion so no LRU lock needed. */
if (!isolated) {
	if (!folio_test_clear_lru(folio))
		goto out;
	isolated = true;
	...
	max_seq = READ_ONCE(lrugen->max_seq);
	max_gen = lru_gen_from_seq(max_seq);
	if (gen == max_gen)
		goto out;   /* 已在最年轻代,无需再提 */
	if (refs <= LRU_REFS_MAX) {
		type = folio_is_file_lru(folio);
		min_gen = lru_gen_from_seq(READ_ONCE(lrugen->min_seq[type]));
		if (gen != min_gen)
			goto out;   /* 只从最旧代提升,防过度保护缓存 */
	} else {
		refs = LRU_REFS_PROTECTED;
	}
	new_gen = (gen + 1UL) % MAX_NR_GENS;
	lru_gen_set_flags(&new_flags, new_gen);
...
out:
	lru_refs_set_flags(&new_flags, min(refs, LRU_REFS_MAX));
▲ 这是"频率引导"的执行点:访问路径在计数达标时把 folio 从最旧代抬到下一代会(gen+1),全程用 folio_test_clear_lru() 短暂隔离 + RCU 读锁,不拿 LRU 锁,所以热路径只有一次原子 cmpxchg。两个 guard 很关键:已在最年轻代(gen == max_gen)不再提;只提升"最旧代"的 folio(gen != min_gen 就跳过),避免把缓存过度保护导致回收滞后。
📈 性能影响
pgpgin -15%、pswpin -14%、pswpout -11%、refault_file -32% 全面下降)——即"少等磁盘/ZRAM I/O"。次类是内存层次:缓存命中率提升,热页留驻、冷页让位。这不是减少 CPU 指令数的 on-CPU 优化,而是减少换页等待的 off-CPU 收益。作者也指出统一 flag 语义改善了 PSI / smaps / readahead 的准确性(可观测性收益,非吞吐)。
folio_mark_accessed()(读页缓存路径)→ refs 递增 → 热页 gen climbing → 回收时热页被 tier 保护 → refault/swap 减少。硬件上,磁盘 swap(NVMe/HDD)比 ZRAM 放大收益(I/O 成本越高收益越大)。
| 场景/用例 | 运行环境 | 主线上游 MGLRU(Before) | MGLRU-FG(After) |
|---|---|---|---|
| Chromium & Node.js | ZRAM swap,48c96t,128G,64 worker,1h | 153029 总请求 | 225664 总请求(+47.4%) |
| MongoDB YCSB workloadb | 16G memcg,48 线程,3 次取均 | 86421.44 ops/s | 95378.50 ops/s(+10.3%) |
| FIO zipf 0.9 | NVMe,16G cgroup,40G 文件,16 jobs | 2350.40 MB/s | 2611.37 MB/s(+11.1%) |
| 内核构建 make -j48 | 3G memcg + 磁盘 swap,16 次不同 swappiness 取均 | real 2m56s,sys 11m06s,refault_file 414k | real 2m49s(-7s),sys 10m39s(-27s),refault_file 280k(-32%) |
| LevelDB Scan/Get | cache_ext 论文 benchmark | 5026.9 ops/s | 5029.7 ops/s(主线上游已优于 CLRU,本系列不倒退) |
| SQLite 热顺序 + 小热区 | 作者复现脚本 | 567.05ms(CLRU 仅 14.51ms) | 10.58ms(恢复并优于 CLRU) |
| grep 冷扫描(>RAM) | 作者复现脚本 | 13694.47ms | 12930.43ms(无退化) |
数据来源:v2 cover letter(2026-08-03)作者 Kairui Song 自报,未独立验证。作者同时说明:一个近期主线上游改动让 Chromium 测试基线"比几个月前快了很多",与本系列无关,但意味着该场景绝对数字可能偏乐观;其他测试(MySQL 等)"looking fine, no regression"。本系列未提供 off-CPU/on-CPU 的细分延迟数据,性能归因(减少 I/O 等待)为解读(AI 分析),基于作者自报的 swap/refault 计数器下降推断。
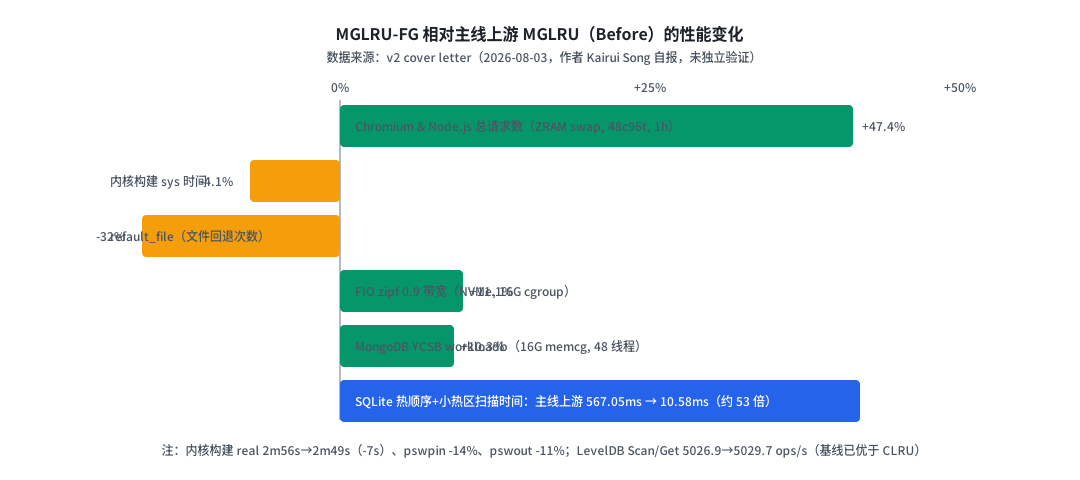
来源:v2 cover letter 数据绘制
🔄 方案演进
本系列从最初提出到当前版本(基于 lore 各版本 cover letter 真实信息):
mm/workingset: simplify and use a more intuitive model 开始)。作者自报 v1 数据:LevelDB GET/SCAN +41%(993.64→1344.72 ops/s)、MongoDB YCSB +16.8%(82127.65→95933.99)。但 refault distance 部分"开销略高于预期(每次 refault 多几十个原子操作 + 一次额外 rstat flush)",作者仍在优化。v2(2026-08-03,15 补丁,"MGLRU-FG and flag cleanup"):砍掉 refault distance(cover letter 明说 "Refault distance is not included yet, can be added later"),聚焦 MGLRU-FG + flag 清理。核心补丁从 v1 06/32(+248/-155)扩展到 v2 09/15(+385/-226,6 文件),因为部分转换工作被合并进来。benchmark 更全面(新增 Chromium/Node、FIO zipf、SQLite/grep、LevelDB 复测),作者自述 "very usable, stable, and performing well"。
- refault distance 被暂缓:v1 含、v2 不含。作者说明缺失的代价是"MGLRU 对工作集剧变响应较慢",后续可再加(链接到 LWN 945266 与 v1 系列)。这是 v1→v2 最大的范围收敛,让系列更小、更易 review。
- 与 workingset reporting 的兼容性:作者主动解释 "gen climbing" 设计看似与 workingset reporting(把代际当作访问间隔标识)冲突,实则不冲突——把 generation 数扩到 64/128 后,refs 驱动的提升停在较旧代(如 oldest+16),剩余新代仍可作为纯时间间隔的 bin(LWN 976985)。
- tier 数固定:MAX_NR_TIERS=4,作者称若未来 tier 超过 4 需另找调节方式,"that shouldn't be hard"。
- v1 cover letter 还提到 RFC 质量提示:几个 helper(如
folio_mark_referenced)"may lead to inaccurate hotness info, only in theory",可后续改进。
💬 讨论焦点
- refault distance 未含入 → MGLRU 对工作集剧变响应慢(v2 cover letter 自述,对应 LWN 945266);
- 一个近期 mainline 改动疑似破坏 MGLRU 公平性,作者称"与本系列无关,但会让 Chromium 测试绝对读数更好,我稍后深查"(v2 cover letter NOTE);
- tier 数固定 4,超限需另设计(v2 cover letter)。
⚠️ 风险与局限
CONFIG_LRU_GEN(MGLRU 开启)。作者数据主要来自磁盘/ZRAM swap 场景,收益大小随换页 I/O 成本缩放。若工作集本身能放进内存,本系列不提供额外收益。
- RFC 未合入:当前只到 v2 RFC,无 sysctl/开关约定,任何生产采用都需自行承担实验风险;
- refault distance 缺失:工作集发生剧烈迁移(如切换热点数据库表)时,MGLRU 响应慢,可能短期命中率下降——作者明确列为待加项;
- flag 语义统一会影响多个子系统:smaps 的 workingset 报告、khugepaged 的"是否 referenced"判断、madvise 的
MADV_REFERENCED语义、readahead 都随之变化,升级后这些用户态/内核组件的行为会变(本系列即为此接入); - 可观测性变化:PSI 的 workingset 判定更准 → PSI 读数会变化(作者称之为修正欠计,但部署方需知 PSI 基线会移动)。
LRU_REFS_WIDTH 扩到 LRU_REFS_WIDTH + 2(借用 PG_workingset/PG_referenced 两位),在 page flags 极其紧张的配置下 tier>2 不可用(作者注释:无 tier>2 时仍能工作,但文件缓存会被更激进地提升)。与未来 workingset reporting 的兼容依赖 generation 数扩展(作者已给方案)。本系列未触碰用户态 ABI。
🔗 交叉引用
v1 cover letter(RFC 00/32) — 初版方案(含 refault distance)+ 三部分拆解
v2 核心补丁 09/15(MGLRU-FG) — 主体实现,6 文件 +385/-226
v1 核心补丁 06/32(MGLRU-FG) — 本文 diff 证据来源,+248/-155
v1 补丁 30/32(refault-distance based re-activation) — v2 暂缓的 refault distance 实现
作者另一系列:mm/mglru: improve reclaim loop and dirty folio handling(v7) — v1 cover 依赖的前置系列
LSF/MM/BPF 2026 议题 — 方案起源(作者 cover [1])
MGLRU 原始 RFC(Yu Zhao, 2022) — 被改进机制的出处
LWN: Refault distance update with MGLRU support — 作者引用 [7],后续待加功能背景
LWN: mm: workingset reporting — 作者引用 [9],未来兼容方向
cache_ext(SOSP 2025) — LevelDB Scan/Get benchmark 来源(作者引用 [5])
YCSB workloadb — MongoDB 测试定义(作者引用 [3])
SQLite/grep 复现脚本 — 热顺序/冷随机复现(作者引用 [6])
相关日报:mm/mglru: use folio_mark_accessed to replace folio_set_active — 本系列依赖的"访问标记"路径(2026-08-05)
Huang Ying: mm: workingset reporting(PATCH v1 0/7, 2024) — workingset reporting 原始系列
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。