mm/slab:kmem_cache_alloc_bulk() 支持任意 gfp — 放宽批量分配约束
💡 一句话总结
在批量内存分配场景(网络收包 NAPI skb 缓存、io_uring 请求批量分配)下,SLUB 分配器的批量接口 kmem_cache_alloc_bulk() 此前会依据调用者传入的 gfp 标志决定"能否在共享的 per-NUMA 节点 barn 锁上自旋等待"——而网络软中断路径用的是 GFP_ATOMIC(不带 __GFP_RECLAIM),会被判为"不能自旋"而改用 trylock,一旦 barn 锁被别的 CPU 占用就直接放弃,掉回更慢的 slab 页分配路径;本补丁确认该接口的调用约定本就要求"中断已使能、可阻塞",于是把自旋决策硬编码为 true、删除 gfp 参数与文档里的 "@flags 必须允许自旋"限制——批量分配在 barn 锁争用时不再轻易掉回慢路径。补丁未提供基准数据,性能收益为逻辑分析(解读(AI 分析))。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 重构(收尾清理)——主导为重构:把 bulk 分配路径中依赖 gfp flags 的自旋决策改为恒真,删除多余参数与文档约束;是 slab_alloc_flags 系列(16 补丁)的收尾补丁 |
| 状态 | 状态(Merged)· 合入版本:Linux 7.2(git describe --contains 首个含入 tag 为 v7.2-rc1) |
| 当前版本 | v2 · 系列第 11/16 补丁 · 2026-06-10 版(commit 的 Link) |
| 版本演进 |
lore 索引命中该补丁的两个消息:v2 11/16(2026-06-10) → v2 11/16 重发(2026-06-12);v1 及系列 cover letter 本次 lore 查询超时未取到(见"方案演进"数据源说明) (系列演进信息主要来自本地 git commit message 的 Link + Reviewed-by 链;lore MCP 本次不可用,如实标注) |
| 作者机构 | Vlastimil Babka(SUSE)<vbabka@kernel.org> |
| 提交日期 | authored 2026-06-10 · 并入 v7.2-rc1(经 slab/for-7.2/alloc_bulk 分支合入) |
| 改动范围 | mm/slub.c,+4/-12 行,1 文件 |
| 核心函数 | alloc_from_pcs_bulk() / barn_replace_empty_sheaf() / kmem_cache_alloc_bulk_noprof() / alloc_slab_obj_exts() / gfpflags_allow_spinning() |
| 原始链接 | git.kernel.org(规范 commit 链接) · lore Message-ID |
| Review / 合入 | Reviewed-by: Suren Baghdasaryan(Google)、Harry Yoo(Oracle)、Hao Li · 由作者(slab 维护者)签名合入 |
📊 速览卡片
特性等级依据:性能提升幅度——无基准数据,收益为逻辑推断(always-spin 提高快速路径成功率);落地难度——纯内核重构、零配置零硬件门槛;兼容性——API 文档约束放宽、行为变化小、风险低;场景覆盖——影响所有 bulk 分配调用方(网络 RX / io_uring)但收益是间接的 → 综合 ★★
🎯 解决什么问题
slab_alloc_flags 系列(v2,16 补丁,作者 Vlastimil Babka)整体解决:slab 分配器内部需要区分"这次分配能否在锁上自旋/阻塞"这一上下文属性,却一直错误地从 gfp flags 反推。系列引入分配器专用的 alloc_flags(如 SLAB_ALLOC_NOLOCK)与 slab_alloc_context 结构,把这些上下文属性显式化并贯穿分配路径,替代 gfpflags_allow_spinning() 这类推断。本补丁(11/16)是系列的收尾:在前置补丁把 alloc_flags 铺到 bulk 路径后,删除 slab 中最后一个 gfpflags_allow_spinning() 使用,完成 gfp 与自旋决策的解耦。
74d224ac "mm/slab: introduce alloc_flags and SLAB_ALLOC_NOLOCK" 的 commit message):内核的 kmalloc_nolock() 是一种非阻塞、只能用 trylock 的自旋锁语义的分配 API,此前靠 gfpflags_allow_spinning(gfp) 识别——即要求 gfp 同时缺 __GFP_DIRECT_RECLAIM 与 __GFP_KSWAPD_RECLAIM。这套推断有两个问题:① 一个并非 nolock 的分配若因其他原因不带 __GFP_RECLAIM(如 GFP_NOWAIT / GFP_ATOMIC),会被误判为 nolock,从而只能用 trylock,成功机会更低;② 早期 boot 阶段受限的 gfp_allowed_mask 也会产生假阳性。本补丁单独针对 kmem_cache_alloc_bulk():commit message 说明该函数是 slab 中 gfpflags_allow_spinning() 的最后一个使用者,而其 kernel-doc 早已要求"调用时中断必须已使能"——意味着调用方必然处于可自旋/可阻塞上下文,所以这个检查是多余的,应直接删掉。
kmem_cache_alloc_bulk() 批量取对象时先消费本 CPU 的 pcs->main sheaf;它耗尽后调 barn_replace_empty_sheaf() 从 barn 换入一个满 sheaf。该函数用 allow_spin 参数决定用 spin_lock_irqsave()(阻塞自旋)还是 spin_trylock_irqsave()(非阻塞,抢不到就失败返回 NULL)。改前 allow_spin = gfpflags_allow_spinning(gfp),即 `!!(gfp & __GFP_RECLAIM)`——GFP_ATOMIC/GFP_NOWAIT 传进来就是 false,barn 锁一被占用就 trylock 失败,统计 BARN_GET_FAIL 并回退到 slab 页慢路径。问题本质:是否可自旋是"调用上下文"属性,不是"gfp 标志"属性,用 gfp 判断既不准确(误判 nolock)、又与 API 契约(中断使能)矛盾。
net/core/skbuff.c 的 napi_skb_cache_get() / napi_skb_cache_get_bulk())在软中断里用 GFP_ATOMIC | __GFP_NOWARN 一次批量分配 NAPI_SKB_CACHE_BULK 个 sk_buff 填充 NAPI 缓存。这是典型的高频、多核并发场景:同一 NUMA 节点的多个 CPU 同时收包,会在共享 barn 锁上竞争。改前锁一被占用即 trylock 失败掉慢路径(要去分配/整理 slab 页,代价更高),在多队列网卡高并发收包时放大延迟;io_uring(io_uring.c 的 __io_alloc_req_refill())用 GFP_KERNEL 批量分配请求结构,改前就走自旋无变化,但同样受益于删掉 gfp 检查的开销。
🧩 核心机制
本补丁把 bulk 分配路径中"能否自旋"的决定从"看 gfp 标志"改成"恒真",并顺势删掉不再需要的 gfp 参数与文档约束——一次接口契约与实际行为对齐的清理。
mm/slub.c,三个点:① alloc_from_pcs_bulk() 删除 gfp 形参,调用处 barn_replace_empty_sheaf(..., /* allow_spin = */ true) 硬编码自旋——这是机制本体;② kmem_cache_alloc_bulk() 的 kernel-doc 删掉 "@flags must allow spinning"——把已成立的调用约定固化到文档;③ alloc_slab_obj_exts() 删掉一段"早期 boot 因 gfp_allowed_mask 可能假阳性"的注释——因为该假阳性源已被系列前置补丁用显式 alloc_flags 消除。为什么这样改:既然 bulk 接口的调用契约(中断使能、可阻塞)已经排除了真正的原子上下文,那么基于 gfp 的 trylock 分支就是死逻辑——它不仅多一次 gfp 位运算与分支,还在锁争用时把本该留在快速路径的分配推入更贵的慢路径。
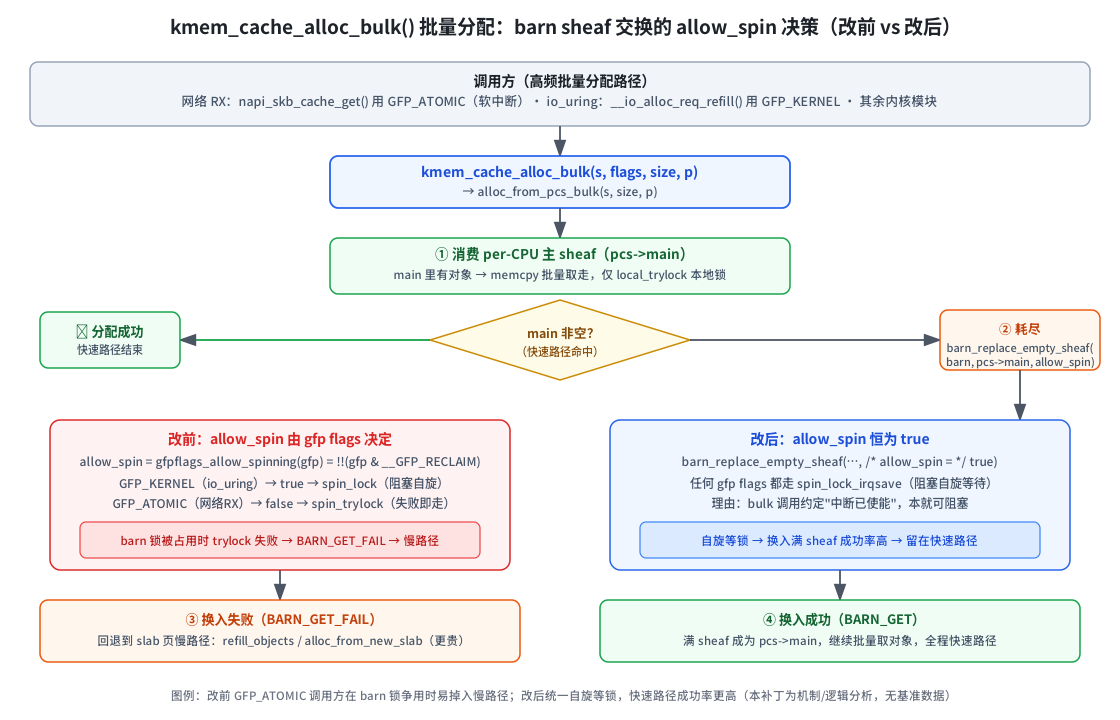
来源:基于 commit
1a787779fe2a 真实 diff 与 mm/slub.c 源码绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| ① 消费本地 sheaf | alloc_from_pcs_bulk(s, size, p) 从 pcs->main memcpy 批量取对象 | 快速路径,仅 local_trylock 本地锁 |
| ② 本地耗尽换池 | barn_replace_empty_sheaf(barn, pcs->main, true) 从节点 barn 换入满 sheaf | 换入成功则继续快速路径 |
| ③ 换入失败 | 统计 BARN_GET_FAIL,返回给上层走 refill_objects() 慢路径 | 从 slab 页分配(代价更高) |
| ④ 决策常数化 | allow_spin 由 gfpflags_allow_spinning(gfp) 改为恒 true | 锁争用时自旋等待而非放弃,③ 发生频率降低 |
 static __fastpath_inline
-unsigned int alloc_from_pcs_bulk(struct kmem_cache *s, gfp_t gfp, size_t size,
-				 void **p)
+unsigned int alloc_from_pcs_bulk(struct kmem_cache *s, size_t size, void **p)
 {
 	...
 		full = barn_replace_empty_sheaf(barn, pcs->main,
-						gfpflags_allow_spinning(gfp));
+						/* allow_spin = */ true);

 		if (full) {
 			stat(s, BARN_GET);
▲ 这段是机制成立的关键:allow_spin 从"gfp 推导"改为恒真,配合删除 gfp 形参。改前 gfpflags_allow_spinning(gfp) 对 GFP_ATOMIC 返回 false,barn_replace_empty_sheaf() 走 spin_trylock_irqsave(),锁忙即返回 NULL(BARN_GET_FAIL);改后统一走 spin_lock_irqsave(),等锁拿到满 sheaf——这正是"放宽批量分配约束"的落点。
  * Allocate @size objects from @s and places them into @p.  @size must be larger
  * than 0.
  *
- * Interrupts must be enabled when calling this function and @flags must allow
- * spinning.
+ * Interrupts must be enabled when calling this function.
▲ 文档把"@flags 必须允许自旋"删掉:实现里已无任何 gfp 位决定是否自旋,约束从 API 层面移除,与"中断必须使能"这一真正的前提保持一致。
📈 性能影响
gfpflags_allow_spinning() 的位运算与分支、去掉一个函数参数——每调用省下极少量指令。off-CPU 锁等待 / 慢路径规避(主要):对 GFP_ATOMIC/GFP_NOWAIT 调用方,改前 barn 锁争用时 trylock 失败即回退到 slab 页慢路径(该路径含分配新 slab、页分配器等更贵操作,含 off-CPU 等待);改后自旋等锁,留在快速路径。整体是"用短暂的自旋等待换取避免更贵的慢路径"——属于 off-CPU 侧减少慢路径的间接收益。
kmem_cache_alloc_bulk(skbuff_cache, GFP_ATOMIC, ...),共享 NUMA 节点 barn 锁竞争最激烈。改前锁争用→trylock 失败→BARN_GET_FAIL→慢路径,且 GFP_ATOMIC 的慢路径还要兼顾"不能阻塞回收"的约束,处理更局促;改后自旋等锁,BARN_GET 命中率提高。其次是 io_uring 批量分配请求(GFP_KERNEL,行为无变化,仅少一次 gfp 检查)。
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| 批量分配快速路径命中率(网络 RX GFP_ATOMIC) | 多核高并发收包,barn 锁争用 | 锁忙时 trylock 失败 → 掉慢路径 | 自旋等锁 → 留在快速路径 |
说明:补丁未提供基准,无实测数字。以上为逻辑分析(解读(AI 分析)),依据是 diff 中 spin_trylock→spin_lock 的行为变化与 BARN_GET_FAIL 回退路径的真实代码。收益成立的前提是 barn 锁确实出现争用;锁无争用时改前改后行为等价(no-op)。
🔄 方案演进
本补丁是 slab_alloc_flags 系列的一部分,其演进体现在系列如何逐步把"自旋决策"从 gfp 推导迁到显式 alloc_flags(基于本地 git commit message 的 Link trailer 与 Reviewed-by 链;lore 全量索引本次超时,未取到 v1/cover letter,如实标注):
slab_alloc_context 辅助结构,先装 caller 地址与请求大小,为减少函数参数铺路,无功能变化。74d224ac(mm/slab: introduce alloc_flags and SLAB_ALLOC_NOLOCK):引入分配器内部
alloc_flags 与 SLAB_ALLOC_NOLOCK,用显式标志取代 gfpflags_allow_spinning() 推断 nolock,消除假阳性;在 alloc_from_pcs() 等路径先行使用——commit message 明确"一些因 gfp 被误判为 nolock 的分配将获得更高成功机会"。574d3961(mm/slab: add alloc_flags to slab_alloc_context):把
alloc_flags 并入 slab_alloc_context,进一步扩散到 ___slab_alloc()、get_from_partial_node() 等;并说明 bulk 路径"调用方都期望允许自旋,故用 SLAB_ALLOC_DEFAULT"。1a787779(本补丁):收尾——bulk 路径最后一个
gfpflags_allow_spinning() 删除,gfp 与自旋决策彻底解耦。
574d3961 已声明 bulk 路径用 SLAB_ALLOC_DEFAULT(允许自旋)是"临时方案,随着 slab_alloc_context 作用域扩大会更明显"——本补丁正是把这一声明兑现为代码事实。commit 带 Suren Baghdasaryan、Harry Yoo、Hao Li 三方 Reviewed-by,说明方向经社区 review 认可。本环境 lore 未取到 v1 版本与系列 cover letter、以及 review 往返讨论,因此"review 具体质疑了什么、作者如何回应"无法从邮件原文核实——如需追查,可依据 lore 链接直接检索该系列线程(链接见交叉引用)。
注:lore 不可用时系列演进/讨论来源为本地 git commit message(Link + Reviewed-by 链),已如实标注。
⚠️ 风险与局限
GFP_ATOMIC/GFP_NOWAIT 的 bulk 调用方(典型是网络 RX)从"锁忙即放弃"变为"自旋等锁"。在极端高争用下,自旋等待会增加单次分配的 CPU 占用与延迟——但这些调用方本就在软中断/进程上下文(中断使能),自旋临界区很短(仅链表操作),代价有限。可观测性:SLUB 的 BARN_GET / BARN_GET_FAIL 统计可对比改前改后慢路径回退频率。
alloc_from_pcs_bulk(s, gfp, size, p) 改为 (s, size, p) 是内部 static 函数,无外部 ABI 影响。kmem_cache_alloc_bulk() 的公开签名不变,现有调用方(网络、io_uring、GPU、memcg 测试)无需改动。
🔗 交叉引用
mm/slab: add alloc_flags to slab_alloc_context — 把 alloc_flags 并入上下文结构,并声明 bulk 路径"调用方都期望允许自旋"(本补丁的伏笔)
mm/slab: introduce slab_alloc_context — 系列前置:引入上下文结构减少函数参数
mm/slab: improve kmem_cache_alloc_bulk(Christoph Hellwig) — 同一周期的相关补丁:把 bulk 返回值改为 bool 并完善 API 文档,与本补丁共同收口 bulk 接口语义
lore:本补丁 v2 11/16(2026-06-10) — commit 的 Link trailer 指向的邮件
lore:本补丁 v2 11/16 重发(2026-06-12) — 系列重发版
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。