mm/khugepaged:mTHP collapse 支持 — 页缓存大页折叠降低 page fault 开销
💡 一句话总结
在内存访问存在碎片/空洞(一个 2MB 区间里只有部分页被占用、其余为 none/zero)的场景下,khugepaged 以前要么折叠成整块 2MB PMD 巨页、要么整个放弃——只要区间内空页超过 max_ptes_none 就完全得不到大页收益。本补丁给 khugepaged 引入 mTHP collapse 支持:扫描阶段用位图记录占用页、折叠阶段用 mthp_collapse() 按自然对齐贪心选择最合适的 mTHP 阶数(16K 到 1MB),使部分占用的区间也能折叠成较小的大页,从而降低 page fault 与 TLB miss。补丁未提供基准数字。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 新特性(feature,使能 khugepaged 折叠 mTHP) |
| 状态 | 状态(Merged)· 合入版本 Linux 7.2(git describe --contains 90ed32d0 → v7.2-rc1,首个包含 tag) |
| 当前版本 | 主线合入版(patch 12/14,系列第 12 篇)· lore 归档 |
| 版本演进 |
系列共 14 篇(LWN 报道,2026-06-05 发布):patch 1-2 泛化 vma 校验/计费 → patch 3-6 泛化 collapse_huge_page → patch 7-9 统计与 tracepoint → patch 10 collapse_possible_orders → patch 11-13 位图扫描 + mTHP 折叠主体(本补丁为第 12 篇) → patch 14 文档lore 在本环境超时,系列规模与演进依据 LWN 报道 + 本地 git 提交链(Link + Reviewed-by/Acked-by 链) |
| 作者机构 | Nico Pache (Red Hat) |
| 提交日期 | 2026-06-05(作者日期)· 2026-06-21 合入(akpm 提交) |
| 改动范围 | mm/khugepaged.c,+138/-8 行,1 文件 |
| 核心函数 | mthp_collapse() / collapse_scan_pmd() / max_order_from_offset() / collapse_possible_orders() / collapse_max_ptes_none() |
| 原始链接 | git.kernel.org commit · lore Message-ID |
📊 速览卡片
特性等级依据:机制方向性强(大页折叠收益已被业界广泛验证)、落地零门槛(纯内核改动、随 7.2 合入即生效)、兼容性好(PMD 折叠行为不变、madv_collapse 不受影响),但补丁未给出实测基准,且收益强依赖碎片/空洞场景——综合 4 原则评 ★★★★(解读(AI 分析))。
🎯 解决什么问题
hugepage_vma_revalidate、alloc_charge_folio、collapse_huge_page 等基础设施使其支持任意 order;本补丁实现核心的扫描位图 + 最优阶数选择算法;后置补丁(第 13 篇起)做避免无谓尝试等收尾。单看本补丁只是 khugepaged.c 一个文件 +138 行,但它把前面所有泛化工作「接通」成了 mTHP 折叠能力,是系列的承上启下核心。
max_ptes_none 就整块放弃。这带来的痛点(commit message 原话支撑 + 逻辑解读):一个 2MB 区间只要有少量空洞就无法折叠成 2MB,结果连较小的大页机会也一并放弃——该区间所有页长期停留在 4K,每次访问都要走小页缺页路径、TLB 覆盖面积小。上游在 6.x 系列已引入 mTHP(multi-size THP,anon 内存支持 order 2~9 多种阶数,THP_ORDERS_ALL_ANON),khugepaged 却仍被钉死在 PMD 阶数上,能力与生态脱节。本补丁就是为了「让 khugepaged 跟上 mTHP 生态,把部分占用的区间也能折叠成较小大页」。
collapse_scan_pmd() 的流程:轻量扫描阶段(持 mmap_read_lock)逐 PTE 统计 none/zero/shared/swap 页数量,一旦 none_or_zero > max_ptes_none 立即 SCAN_EXCEED_NONE_PTE 提前放弃;扫描通过后才进入 分配阶段(释放 mmap 锁)与 重折叠阶段(mmap_write_lock),调用 collapse_huge_page(..., HPAGE_PMD_ORDER) 只做 2MB 一种阶数。两个缺陷:① 扫描阶段用 PMD 的 max_ptes_none 阈值提前终止,mTHP 候选根本没机会被评估;② 折叠函数写死 PMD order,无法产出较小大页。
- 数据库 / 内存索引:B+ 树页、哈希桶、日志结构存储常是「区间内部分页热、部分页冷或未分配」的稀疏布局,2MB 对齐区间里天然有空洞,PMD 折叠整块失败。
- 云虚拟机 / 容器内存:guest 内存按需分配,2MB 大页对齐区间常只填充一部分 4K 页,剩余为 none。
- 共享库 / 稀疏 mmap:代码段与堆之间的空洞、稀疏映射文件的预读边界。
🧩 核心机制
核心思路一句话:扫描阶段放宽「空页」限制、把占用情况记进位图;折叠阶段用位图按自然对齐贪心选阶数——把「一个 PMD 一次决策(2MB 或不折叠)」拆成「一个 PMD 多次决策(多个 mTHP 区间)」。
enabled_orders != BIT(HPAGE_PMD_ORDER))时,把扫描用的 max_ptes_none 放宽到 KHUGEPAGED_MAX_PTES_LIMIT(=511),避免「空页超标」提前终止;同时每看到一个占用页就用 __set_bit(i, cc->mthp_present_ptes) 把位置记入 512-bit 位图。为什么这么改:扫描阶段过早终止会漏掉 mTHP 候选——即使整个 2MB 空页多,其中某个 64K 子区间可能完全密集,必须在扫描阶段把全部 PTE 看完、把占用位图建全,折叠阶段才能做局部判断。② 折叠阶段(mthp_collapse,本补丁核心):基于位图,从 offset=0 开始贪心:对每个自然对齐 offset,先试最高的已使能阶数,用
bitmap_weight_from() 统计该区间占用 PTE 数,若 占用数 ≥ nr_ptes − max_ptes_none 就调 collapse_huge_page(mm, addr, ..., order) 尝试折叠;成功则跳过该区间,失败则降一阶在同一 offset 重试,直到最小阶数 order 2(16K,KHUGEPAGED_MIN_MTHP_ORDER,与 THP_ORDERS_ALL_ANON 下限一致);然后 offset 跳过已处理区域,新阶数由 __ffs(offset) 的自然对齐限制决定。③ 防「折叠蠕变」:mTHP 折叠拒绝含 swap 或共享页的区间,且
collapse_max_ptes_none() 只支持 max_ptes_none ∈ {0, HPAGE_PMD_NR−1}——否则一次折叠引入的新 none 页会让下次扫描再次满足升阶条件,导致 mTHP 被不断「promote」到更高阶。这是作者明确的正确性设计,防止折叠抖动。
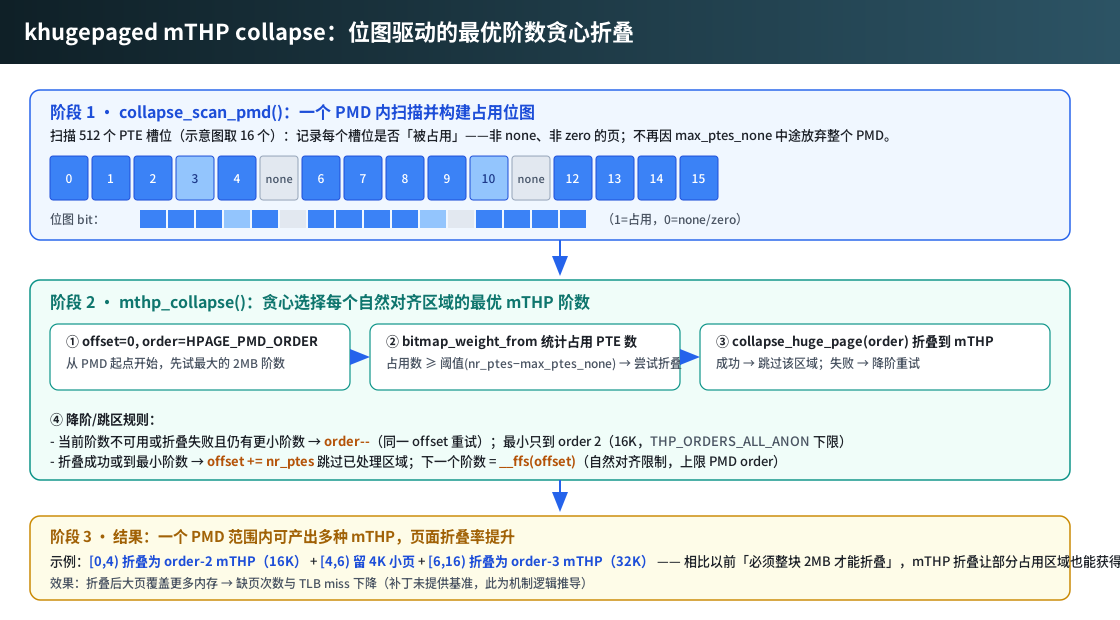
来源:基于真实补丁 diff(mthp_collapse / collapse_scan_pmd)绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 1 扫描 | bitmap_zero(cc->mthp_present_ptes) + 遍历 PTE,占用页 __set_bit(i, ...) | 把「哪些 4K 槽位被占用」建成位图,供折叠阶段复用,避免重复遍历页表 |
| 2 判阶 | enabled_orders = collapse_possible_orders(vma, vm_flags, tva_flags) | 确定该 VMA 允许哪些 mTHP 阶数,只折叠允许的阶数 |
| 3 选阶 | max_order_from_offset(offset) → bitmap_weight_from(...) 统计占用 | 按自然对齐限制取最高可尝试阶数,用位图快速统计占用数是否达标 |
| 4 折叠 | collapse_huge_page(mm, addr, ..., order) | 按选定的 mTHP 阶数执行实际折叠(后续补丁支持任意 order) |
| 5 推进 | 成功 → offset += nr_ptes;失败 → order-- 重试 | 贪心覆盖整个 PMD 区间,每个密集子区间尽量拿最大可用大页 |
+static unsigned int max_order_from_offset(unsigned int offset)
+{
+	if (offset == 0)
+		return HPAGE_PMD_ORDER;
+	return min_t(unsigned int, __ffs(offset), HPAGE_PMD_ORDER);
+}
+
+static enum scan_result mthp_collapse(struct mm_struct *mm,
+		unsigned long address, int referenced, int unmapped,
+		struct collapse_control *cc, unsigned long enabled_orders)
+{
+	...
+	while (offset < HPAGE_PMD_NR) {
+		nr_ptes = 1UL << order;
+		if (!test_bit(order, &enabled_orders))
+			goto next_order;
+
+		max_ptes_none = collapse_max_ptes_none(cc, NULL, order);
+		nr_occupied_ptes = bitmap_weight_from(cc->mthp_present_ptes,
+						      offset, offset + nr_ptes);
+
+		if (nr_occupied_ptes >= nr_ptes - max_ptes_none) {
+			collapse_address = address + offset * PAGE_SIZE;
+			ret = collapse_huge_page(mm, collapse_address, referenced,
+						 unmapped, cc, order);
+			...
+		}
+next_order:
+		if (order > KHUGEPAGED_MIN_MTHP_ORDER &&
+			(enabled_orders & GENMASK(order - 1, 0))) {
+			order--;
+			continue;
+		}
+next_offset:
+		offset += nr_ptes;
+		order = max_order_from_offset(offset);
+	}
+}
▲ 这段是机制成立的关键:max_order_from_offset() 用 __ffs(offset) 保证每次尝试的大页都满足自然对齐(大页起始地址必须是阶数的倍数);mthp_collapse() 的 while 循环把「高位贪心、失败降阶、成功跳区」表达得清清楚楚——这是「部分占用区间也能折叠」的算法根源。整段逻辑与 commit message 中 7 步算法逐条对应。
📈 性能影响
bitmap_weight_from)比逐 PTE 重扫更省。注意这是「折叠收益」,khugepaged 后台折叠本身仍是异步成本,本补丁并未消除折叠自身的开销。
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| 碎片化内存区间(部分占用) | 任意使能 mTHP 的 Linux 7.2+ 内核 | 2MB 折叠失败 → 全 4K | 折叠为 16K~1MB mTHP → 大页覆盖提升(补丁未提供基准,此行为推断) |
| 连续密集区间(2MB 可行) | 同上 | 折叠为 2MB PMD | 仍折叠为 2MB PMD(行为不变) |
说明:补丁未提供基准(commit message / LWN 报道均无数字)。上表为基于机制的定性推断(解读(AI 分析));真实收益需在碎片负载下实测 page fault 次数 / TLB miss 计数 / 延迟,本报告不编造数字。
on-CPU vs off-CPU:缺页处理与 TLB miss 均为 on-CPU 成本(在 CPU 上执行缺页/页表遍历);折叠本身是后台异步工作,不阻塞应用执行(off-CPU 等待无关)。因此本补丁主要压缩 on-CPU 的访存/缺页开销。
🔄 方案演进
本补丁是 14 篇系列中的第 12 篇;系列内演进如下(基于 LWN 报道 + 本地 git 提交链;lore 在本环境超时,无法逐一核对各 patch 的 v1→vN 变化):
hugepage_vma_revalidate / alloc_charge_folio 支持任意 order(前提)patch 3-6:把
max_ptes_* 处理抽成 helper、泛化 __collapse_huge_page_* / collapse_huge_page 支持任意 order(前提)patch 7-9:跳过「向更小阶数折叠」、每阶折叠失败统计、mTHP 阶数 tracepoint(配套)
patch 10:
collapse_possible_orders helper,统一判断 VMA 允许的阶数(前提)patch 11-13:位图扫描 + mTHP 折叠主体(本补丁 90ed32d0 为第 12 篇,实现扫描位图 + mthp_collapse 贪心算法)
patch 14:文档(Documentation)
合入主线:本补丁由 Andrew Morton(mm 维护者)2026-06-21 提交,随
v7.2-rc1 进入 Linux 7.2。
⚠️ 风险与局限
enabled_orders == BIT(HPAGE_PMD_ORDER)),行为与旧版完全一致(no-op),本补丁不改变 PMD 折叠。② 受益依赖碎片/空洞场景:连续密集区间本就能 2MB 折叠,收益集中在「部分占用区间」。③ min order 2(16K)下限:比 16K 更小的阶数(如 order 0/1 的 4K/8K)不参与折叠,THP_ORDERS_ALL_ANON 之外的内存类型不在范围。④ 含 swap 或共享页的区间被拒绝折叠,此类区间无收益。
khugepaged_max_ptes_none,mTHP 折叠会 pr_warn_once 并回退到 0(不引入新空页)——这不是错误但会产生内核警告日志,运维需知晓该限制。② 折叠次数可能上升:一个 PMD 区间从「最多一次 2MB 折叠」变为「可能多次 mTHP 折叠」,khugepaged 后台工作量可能增加(每阶折叠都要 alloc/重锁),对 CPU 使用率有潜在影响(解读(AI 分析),无实测)。③ 大页内存占用增加:折叠产出更多大页,本质是「用更多内存换更少缺页」,内存压力大时可能加重回收负担(mTHP 的通用权衡,非本补丁特有)。
madv_collapse(MADV_COLLAPSE)语义不变;② 依赖 mTHP 基础(thp_vma_allowable_orders、THP_ORDERS_ALL_ANON),已在 Linux 6.8+ 就绪;③ 对用户态透明,应用无需修改。兼容性风险低。
🔗 交叉引用
系列 cover letter(第 1 篇) — 系列动机与整体方案(lore 归档)
前置补丁 collapse_possible_orders(系列第 10 篇) — 本补丁依赖的阶数判断 helper
前置补丁 generalize collapse_huge_page(系列第 6 篇) — 本补丁调用的折叠函数已支持任意 order
后置补丁 run khugepaged for all orders(Baolin Wang) — 让 khugepaged 扫描全部阶数(紧接本系列落地)
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。