rtla/osnoise: Track IPIs —— 把跨 CPU 中断干扰从 IRQ 计数中拆出来
💡 一句话总结
在 CPU 隔离 / 实时延迟分析场景下,IPI(跨处理器中断)打到"本应隔离"的 CPU 上是延迟毛刺的常见元凶,但单个 IPI 往往不触发延迟阈值,只能在 24 小时长跑 timerlat 的尾端才暴露;本系列为 rtla/osnoise 工具新增 --ipi 选项,通过使能 ipi_send_cpu / ipi_send_cpumask 内核 trace 事件、在内核侧按被监控 CPU 过滤、并在用户态按 CPU 累加计数,把 IPI 干扰从 osnoise 的 IRQ 计数中单独拆出一列,帮助运维快速定位隔离配置失误——这是纯用户态工具增强(非内核补丁),无性能基准数据,价值在"诊断能力增强"而非直接提升吞吐或延迟。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 新特性(feature)——rtla/osnoise 工具新增 IPI 追踪诊断能力(非内核性能优化补丁) |
| 状态 | In Review(v4,Red Hat 提出) |
| 当前版本 | v4 · lore 链接 |
| 版本演进 |
v1(含内核 osnoise_sample 改动,无独立链接)→ v2(改为纯用户态,无独立链接)→
v3(07-15)→
v4(08-04,rebased 到 v7.2-rc4)(v1/v2 未在 lore 归档中获取到独立消息链接,按 cover letter 修订说明归纳;v3/v4 链接已核验) |
| 作者机构 | Valentin Schneider(Red Hat) |
| 提交日期 | 2026-08-04(v4,UTC 17:42) |
| 改动范围 | tools/tracing/rtla/(src/osnoise_top.c、osnoise.c、common.c、common.h、osnoise.h、cli.c、cli_p.h、trace.c)+ Documentation/tools/rtla/,共 9 文件(6 补丁,见"系列整体分析"逐补丁统计) |
| 核心函数 | osnoise_init_top() / osnoise_ipi_cpu_handler() / osnoise_ipi_cpumask_handler() / account_ipi() / osnoise_init_ipi_filters() / osnoise_init_trace_tool() |
| 评审标签 | Suggested-by: Tomas Glozar(Red Hat,patch 4/6 过滤器优雅降级) |
| 原始链接 | cover letter Message-ID: 20260804174242.2288433-1 |
📊 速览卡片
🎯 解决什么问题:系列整体分析
rtla osnoise top 展示每个 CPU 的 IRQ/Softirq/Thread 干扰计数与最大采样延迟。IPI(Inter-Processor Interrupt,跨处理器中断)到达某 CPU 时以中断形式打断采样循环,因此一直隐含在 IRQ 计数里,无法单独看到。
本系列定位:给 osnoise top 新增
--ipi 选项,使能 ipi_send_cpu / ipi_send_cpumask 两个内核 trace 事件,在用户态按被监控 CPU 累加 IPI 次数,把"IPI 干扰"从 IRQ 黑盒里拆成独立一列;同时让保存的 trace 文件也带上 IPI 事件,便于离线分析。整系列 6 补丁是用户态工具增强(v2 起全部在 userspace,无内核改动),不改变内核行为。
IPI 追踪的价值:隔离/实时场景下,IPI 打到隔离 CPU 是最常见的延迟毛刺来源之一,但单个 IPI 通常不会让延迟越过阈值——它是与其它干扰叠加才导致毛刺。有了独立的 IPI 计数,运维能直接看到"这个隔离 CPU 每秒被多少 IPI 打扰",在毛刺出现前就发现隔离配置失误。
ipi:ipi_send_cpu(单 CPU 目标)和 ipi:ipi_send_cpumask(广播/组播目标)两个 trace 事件,但 rtla/osnoise 默认不开启它们,因此用户看不到 IPI 维度。本系列在用户态开启这两个事件、读取其 cpu/cpumask 字段并按被监控 CPU 计数——不触碰内核,只新增可观测性。
🧩 核心机制
整条链路:--ipi 开关 → 使能两个 IPI trace 事件 →(可选)内核事件过滤器只留被监控 CPU → 用户态事件回调读字段并按 CPU 计数 → osnoise top 新增 IPI 列 / trace 文件同步记录。核心是"让 IPI 以事件形式流到用户态,再按目标 CPU 记账"。
tools/tracing/rtla/src/ 的 osnoise 工具链,是一个串行递进的 6 补丁:
- 1/6 加开关:
OSNOISE_OPT_IPI定义--ipi长选项(布尔),写入common_params.ipi,并补文档。v3 起故意只用长选项,把短-i留给别的用途。 - 2/6 计数主体:
osnoise_init_top()在params->ipi时开启ipi:ipi_send_cpu与ipi:ipi_send_cpumask事件,注册两个回调;account_ipi()把每 CPU 的ipi_count累加;top 表头与每行新增 IPI 列。 - 3/6 内核侧过滤:当用
-c只追踪部分 CPU 时,借助内核 trace 过滤器(cpu & CPUS{...}/cpumask & CPUS{...})让 IPI 事件只在目标 CPU 命中时产生,减少无关事件。ipi_send_cpumask仍需用户态重算交集(事件只保证"部分目标被监控")。 - 4/6 优雅降级:v6.6 之前的内核没有 39f7c41c908b(cpumask 字段过滤),过滤器会失败;此时回退到
osnoise_ipi_cpu_unfiltered_handler,在用户态用CPU_ISSET()自己过滤(Tomas 建议)。 - 5/6 清理残留过滤器:用户自定义
-e事件时,无条件清掉预置过滤器,保证从已知状态开始。 - 6/6 trace 文件同步:把过滤逻辑重构为可复用的
osnoise_init_ipi_filters();osnoise_init_trace_tool()改为接收 params,在保存 trace 文件时同样使能 IPI 事件 + 过滤器,使离线文件与 top 分析口径一致。
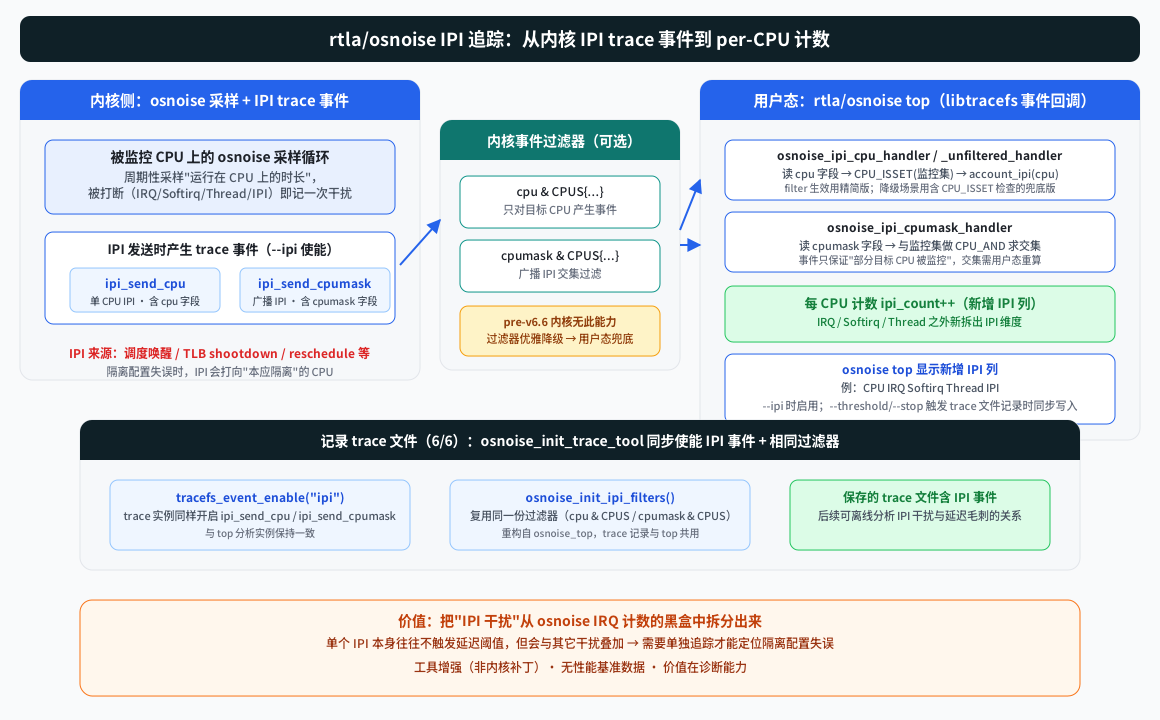
来源:基于 lore 真实补丁 diff(v4)绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 使能事件 | tracefs_event_enable(inst, "ipi", "ipi_send_cpu"/"ipi_send_cpumask") | 让内核在 IPI 发送时产生 trace 事件(默认未开启) |
| 事件过滤 | tracefs_event_file_write(..., "filter", "cpu & CPUS{...}") | 只对 -c 指定的被监控 CPU 产生事件,减噪声(pre-v6.6 优雅降级) |
| 回调计数 | 读 cpu/cpumask 字段 → CPU_ISSET/CPU_AND → account_ipi() | 把每次 IPI 归到目标 CPU,累加 ipi_count |
| top 展示 | osnoise_top_print() 输出新增 IPI 列 | 运维直接看到每 CPU 收到的 IPI 数(IRQ/Softirq/Thread 之外新维度) |
| trace 记录 | osnoise_init_trace_tool() 同步使能 IPI 事件 + 过滤器 | 保存的 trace 文件含 IPI 事件序列,可离线关联毛刺 |
+static void account_ipi(struct osnoise_tool *tool, unsigned long long dst_cpu)
+{
+ struct osnoise_top_cpu *cpu_data;
+ struct osnoise_top_data *data;
+ unsigned long long inc = 1;
+
+ data = tool->data;
+ cpu_data = &data->cpu_data[dst_cpu];
+
+ update_sum(&cpu_data->ipi_count, &inc);
+}
+
+/*
+ * osnoise_ipi_cpu_handler - this is the handler for single CPU IPI events.
+ */
+static int
+osnoise_ipi_cpu_handler(struct trace_seq *s, struct tep_record *record,
+ struct tep_event *event, void *context)
+{
+ struct osnoise_tool *tool;
+ struct osnoise_params *params;
+ unsigned long long dst_cpu;
+ struct trace_instance *trace = context;
+
+ tool = container_of(trace, struct osnoise_tool, trace);
+ params = to_osnoise_params(tool->params);
+
+ tep_get_field_val(s, event, "cpu", record, &dst_cpu, 1);
+
+ if (CPU_ISSET(dst_cpu, ¶ms->common.monitored_cpus))
+ account_ipi(tool, dst_cpu);
+
+ return 0;
+}▲ 这是 2/6 的计数核心:account_ipi() 把目标 CPU 的 ipi_count 加一(复用已有 update_sum() 聚合逻辑);osnoise_ipi_cpu_handler() 从事件里取出 cpu 字段,用 CPU_ISSET 确认它是被监控 CPU 才记账。关键在"dst_cpu 判定"——IPI 是发给别人的,收到事件的是任意 CPU,必须按事件携带的目标 CPU 归属,而不是按执行回调的 CPU 归属。
+int osnoise_init_ipi_filters(struct osnoise_tool *tool,
+			    struct common_params *params,
+			    bool *filters_enabled)
+{
+	char filter[MAX_PATH];
+	int retval;
+	/*
+	 * If tracing on a subset of possible CPUs, leverage the kernel filtering
+	 * infrastructure to only generate events on traced CPUs.
+	 * Older kernels (pre v6.6) may have the IPI events but not the ability
+	 * to filter them, so allow that to fail gracefully.
+	 */
+
+	snprintf(filter, ARRAY_SIZE(filter), "cpu & CPUS{%s}\n", params->cpus);
+	retval = tracefs_event_file_write(tool->trace.inst,
+					  "ipi", "ipi_send_cpu", "filter",
+					  filter);
+	if (retval < 0) {
+		debug_msg("Could not set ipi_send_cpu CPU filter\n");
+		*filters_enabled = false;
+		return 0;
+	}
+
+	snprintf(filter, ARRAY_SIZE(filter), "cpumask & CPUS{%s}\n", params->cpus);
+	retval = tracefs_event_file_write(tool->trace.inst,
+					  "ipi", "ipi_send_cpumask", "filter",
+					  filter);
+	if (retval < 0) {
+		/*
+		 * If we managed to set up the previous filter but not
+		 * this one, something's really wrong
+		 */
+		err_msg("Could not set ipi_send_cpumask CPU filter\n");
+		*filters_enabled = false;
+		return -1;
+	}
+
+	*filters_enabled = true;
+	return 0;
+}
▲ 这是 6/6 抽取的过滤器初始化:把"按被监控 CPU 过滤 IPI 事件"的逻辑从 osnoise top 里抽成公共函数,供 trace 文件记录复用。核心在 cpu & CPUS{cpus} 语法——内核 trace 过滤器只让目标 CPU 在被监控集合内的事件通过;写失败时(pre-v6.6)不报错退出,而是返回 0 并置 filters_enabled=false,让调用方回退到用户态过滤(patch 4/6)。
📈 性能影响
--ipi 能直接看到每 CPU 的 IPI 计数与 trace 文件里的 IPI 事件序列,把根因从"猜"变成"看"。间接收益:更快定位隔离配置失误 → 减少无效排查时间 → 缩短毛刺窗口。这是对"性能问题定位效率"的改善,不是对运行时性能的改善。
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| 定位隔离 CPU 的 IPI 干扰 | rtla osnoise top + --ipi(任意带 ipi trace 事件的内核) | IPI 混在 IRQ 计数中,不可见 | IPI 独立成列 + trace 文件含 IPI 事件(可观测性增强) |
说明:补丁未提供基准数据(纯用户态工具增强,无 before/after 性能指标)。上表"改进前/后"为能力差异,非性能数字,属"解读(AI 分析)"。作者在 cover letter 中未声称任何吞吐/延迟收益。
🔄 方案演进
本系列从最初提出到 v4 的演进过程(基于 cover letter 修订说明 + lore 各版本真实信息):
osnoise_sample 里加改动 + 用户态配合。v2:删除全部内核改动,改为纯用户态——Tomas Glozar 指出这样"部署到旧内核容易得多"(引 v3 cover letter)。
v3(07-15):删除短选项
-i(把该标志位留空给其它用途);重排 top 表头打印;修复 tracefs_event_file_write() 返回值处理;IPI 过滤器在旧内核上优雅失败;为 -e 事件清理预置过滤器确保已知状态。v4(08-04):rebased 到 v7.2-rc4;修正 changelog 一处笔误。功能相对 v3 基本稳定。
内核 vs 用户态:v1 在内核采样里动手,v2 起全部搬用户态(Tomas 建议,兼顾旧内核可部署性)。
选项命名:Tomas 在 v3 2/6 上追问选项名("这是现在的 --irq 吗?")并自答"
s/irq/ipi/"(message-id CAP4=nvSsYuibT7Oq-hAF9b=dZx==FcR1bK5d3zNmYcWgAZmCGQ);v3 起只用长选项 --ipi。优雅降级:过滤能力依赖 39f7c41c908b(v6.6 才有的 cpumask 字段过滤),Tomas 建议让过滤器失败可接受并回退用户态过滤(patch 4/6 的 Suggested-by)。
⚠️ 风险与局限
ipi:ipi_send_cpu / ipi:ipi_send_cpumask trace 事件(CONFIG_TRACING 且事件存在,主流内核均有);② 事件过滤需要 39f7c41c908b(v6.6+)才支持"按 cpumask 字段过滤"——旧内核会优雅降级为用户态过滤,功能仍在但事件量更大;③ 收益只对"隔离/实时且确有 IPI 干扰"的场景成立,普通服务器上 IPI 干扰本就是正常现象,多出一列价值有限。
--ipi 会让每一次 IPI 都写一条 trace 记录。在 IPI 高频(如大规模 TLB shootdown、频繁跨核唤醒)的机器上,trace 缓冲占用与 tracing 本身的开销可能不小,而 osnoise 恰恰在测延迟,额外的 tracing 开销本身就是一种噪声——这是分析工具固有的"观测干扰"风险。好在它是 --ipi 显式开启(opt-in),默认不启用,不改变默认路径。建议在低干扰窗口短时开启、或配合 -c 子集过滤控制事件量。部署:rtla 是内核源码树内工具(tools/tracing/rtla),需随内核源码编译安装;无新增内核依赖,旧内核也可用(v2 的设计目标)。
可观测性:新增 IPI 列是"诊断信号"而非内核计数器,不改变 tracefs 语义,对既有依赖无影响。
tep_get_field_val、tracefs_event_file_write)依赖既有库能力。对 ipi_send_cpumask 事件,内核过滤器只保证"部分目标被监控"就产生事件,用户态必须重算交集(patch 3/6 已处理),否则会高估 IPI 计数——这是该方案内在的精确性边界。
--ipi 长选项;④ 建议过滤器优雅降级(patch 4/6 落实,Suggested-by)。截至 v4 发布,未发现未解决的 NACK 或阻塞性质疑(若后续有维护者讨论将补充)。
🔗 交叉引用
01/6 · rtla/osnoise: Add IPI tracking cmdline option — 新增 --ipi 选项(+9/-0,4 文件)
02/6 · rtla/osnoise: Record IPI count in osnoise top — 计数主体(+115/-1)
03/6 · rtla/osnoise: Leverage IPI event filters when tracing a subset of CPUs — 内核侧事件过滤(+33/-5)
04/6 · rtla/osnoise: Allow IPI filters to gracefully fail — pre-v6.6 优雅降级(+45/-4)
05/6 · rtla: Unconditionally clean any pre-existing filters for user-provided events — 清理残留过滤器(+4/-0)
06/6 · rtla/osnoise: Trace IPI events when recording a trace file — trace 文件同步记录(+80/-36,5 文件)
--ipi 选项说明在此文档新增osnoise tracer 文档 — 内核侧采样循环原理(IRQ/Softirq/Thread 噪声来源)
commit 39f7c41c908b(tracing/filters: Enable filtering a cpumask field by another cpumask) — 过滤器优雅降级所依赖的内核能力(v6.6)
v3 cover letter(07-15) — 上一版,含 v1→v2→v3 修订说明与用户态化动机
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。