mm/slab: introduce kmalloc_flags()
💡 一句话总结
slab 分配器在为自己维护簿记结构(per-CPU 的 sheaf 对象容器、对象扩展 obj_ext 数组)而发起嵌套 kmalloc 时,分配可能递归回同一个分配器、或在不该自旋的上下文里自旋等待锁;本补丁引入一个能接收内部 alloc_flags 的 kmalloc_flags() 分配入口,使嵌套分配可同时携带"禁止递归 / 免对象扩展 / 非自旋"三类内部策略,并按 alloc_flags 自动分流到普通自旋路径或非自旋的 kmalloc_nolock() 路径,为系列后续彻底移除公开 GFP 标志 __GFP_NO_OBJ_EXT 铺路。补丁未提供性能基准数据,收益为逻辑分析(解读(AI 分析))。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 重构 / 内部 API 基础设施(性能前提:为分配路径的递归防护与自旋分流提供统一入口) |
| 状态 | Merged —— 已合入主线 Linux 7.2(v7.2-rc1 起,rc1 于 2026-06-28 发布;commit 于 2026-06-15 合入 slab 树,经 slab-for-7.2 并入主线的 merge f8115f0e8a05) |
| 当前版本 | v2(slab_alloc_flags-v2 系列,patch 14/16)· lore Link(来自 commit 的 Link: 标签) |
| 版本演进 |
v1 → v2(2026-06-10 发布系列) (本补丁为系列第 14 个;v1 系列详情未能从 lore 索引拉取——本环境 lore MCP 未收录该 slab 系列,见"方案演进"章;v2 已是合入版) |
| 作者机构 | Vlastimil Babka(SUSE)<vbabka@kernel.org>(slab 子系统维护者) |
| 提交日期 | authored 2026-06-10 · committed 2026-06-15 |
| 改动范围 | mm/slab.h + mm/slub.c,+56/-12 行,2 文件 |
| 核心函数 | kmalloc_flags() / __kmalloc_flags_noprof() / __kmalloc_nolock_noprof() / __do_kmalloc_node() / alloc_flags_allow_spinning() |
| 原始链接 | git.kernel.org(规范 commit 链接) |
| Review | Reviewed-by: Hao Li、Suren Baghdasaryan、Harry Yoo (Oracle)(三人都出现在本补丁与系列后续补丁的 Reviewed-by 链上) |
📊 速览卡片
特性等级依据:本补丁是基础设施/重构,无独立实测数据,收益需整个 slab_alloc_flags 系列合入(含 sheaf 分配器 + kmalloc_nolock 路径)才体现;但落地为零门槛(纯内核内部改动、无配置、无特殊硬件)、向后兼容、且影响全局 kmalloc 分配路径,故给 ★★★。
🎯 解决什么问题
slab_alloc_flags-v2 是 Vlastimil Babka 在 2026-06-10 发布的 16 补丁系列,随 Linux 7.2 合入。系列整体要解决的问题:把 slab 分配器的"内部策略"(禁止递归、免对象扩展、非自旋)从公开的 GFP 标志迁移到分配器私有的 alloc_flags,最终在 patch 15/16 移除 slab 内对 __GFP_NO_OBJ_EXT 的全部使用。本补丁(patch 14)是系列的核心 API 前提——先引入接收 alloc_flags 的 kmalloc_flags() 入口;patch 15(30222639602c)与 patch 16(71553a606759)才是真正把 obj_ext 数组与 sheaf 容器两个调用方迁移过来的"收尾"补丁。只看本补丁容易只见"加了个函数"而看不到整条链。
__GFP_NO_OBJ_EXT with an alloc flag that prevents kmalloc recursion. For that we need a version of kmalloc() that takes alloc_flags and use it in places that perform these potentially recursive kmalloc allocations (of sheaves or obj_ext arrays)." 即:slab 内部已有 alloc_flags 机制后,可以用它取代 __GFP_NO_OBJ_EXT 来防递归,但需要一个"能传 alloc_flags 的 kmalloc"入口——就是本补丁的 kmalloc_flags()。更深一层的理由写在 patch 15 的 commit message:"gfp flags are a scarce resource, unlike slab's alloc_flags"——GFP 标志位是稀缺资源,不应被 slab 内部的簿记策略占用。这两处都是作者原话,非推断。
struct slab_sheaf;② obj_ext 对象扩展数组——启用 memcg / alloc_tag 记账时,每个 slab 要挂一个 struct slabobj_ext 数组。问题在于这类"嵌套 kmalloc"可能递归回同一个 kmalloc cache(sheaf→sheaf→…),或在不该阻塞的上下文(已持有 per-CPU 锁、原子上下文)里自旋等锁。此前这套防递归/免扩展/非自旋的逻辑散落在公开 GFP 标志(__GFP_NO_OBJ_EXT)与 kmalloc_nolock() 的硬编码特判里,没有一个入口能把这些内部策略统一传下去。
kmalloc_flags() 是承载这些策略的分配入口🧩 核心机制
一句话机制:kmalloc_flags() 是唯一的"接收内部 alloc_flags 的 kmalloc 变体",它把 alloc_flags 装进 struct slab_alloc_context,再根据其中是否含 SLAB_ALLOC_NOLOCK 决定走普通自旋路径还是非自旋路径。
kmalloc_flags(size, gfp, alloc_flags, node) 在 mm/slab.h 声明(经 alloc_hooks() 与 kmalloc_token 走与 kmalloc() 相同的 alloc-tag/KASAN 记账管线)。② 分流逻辑:核心函数
__kmalloc_flags_noprof() 构造 slab_alloc_context 后调 alloc_flags_allow_spinning() 判断:允许自旋 → 走标准路径 __do_kmalloc_node();含 SLAB_ALLOC_NOLOCK → 走非自旋 __kmalloc_nolock_noprof()。这样"嵌套分配"就不用像以前那样硬编码特判,而是由调用方用 alloc_flags 声明自己的约束。③ 支撑重构:为让两条路径共享同一套上下文,把原
_kmalloc_nolock_noprof() 的实现拆成接收 slab_alloc_context 的 __kmalloc_nolock_noprof() 核心 + 一个薄包装 _kmalloc_nolock_noprof()(对外 API 行为不变)。之所以这样设计:把"走哪条路径"的决策从"调用方记得调用不同函数"升级为"调用方用 flags 声明约束、入口自动分流",语义更清晰,也为 patch 15/16 迁移两个调用方提供了统一落点。
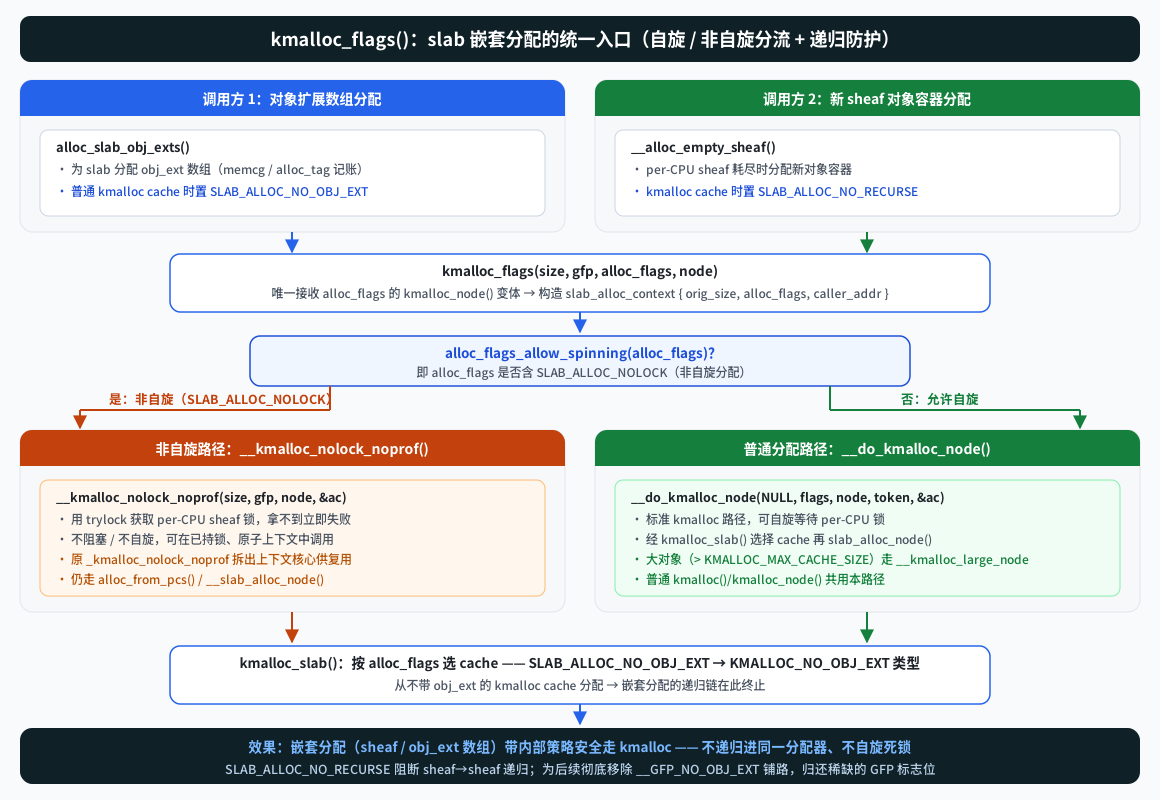
来源:基于本地内核 git(commit f6d50ab29afd 及系列后续补丁)真实 diff 绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 1 | 嵌套调用方(alloc_slab_obj_exts() / __alloc_empty_sheaf())把内部 alloc_flags 传给 kmalloc_flags() | 把"禁止递归 / 免对象扩展 / 非自旋"策略随分配一起传入 |
| 2 | __kmalloc_flags_noprof() 构造 slab_alloc_context,调 alloc_flags_allow_spinning() | 按 SLAB_ALLOC_NOLOCK 决定自旋还是非自旋 |
| 3 | 非自旋 → __kmalloc_nolock_noprof()(trylock,拿不到即失败) | 在已持锁 / 原子上下文安全分配,避免自旋死锁 |
| 4 | 允许自旋 → __do_kmalloc_node()(kmalloc_slab() 依 SLAB_ALLOC_NO_OBJ_EXT 选 KMALLOC_NO_OBJ_EXT cache) | 从不带 obj_ext 的 cache 分配对象,终止递归链 |
diff --git a/mm/slab.h b/mm/slab.h
index d86203131f58..482b8e0fe797 100644
--- a/mm/slab.h
+++ b/mm/slab.h
@@ -26,6 +27,18 @@ static inline bool alloc_flags_allow_spinning(const unsigned int alloc_flags)
 	return !(alloc_flags & SLAB_ALLOC_NOLOCK);
 }

+void *__kmalloc_flags_noprof(DECL_TOKEN_PARAMS(size, token), gfp_t flags,
+				  unsigned int alloc_flags, int node)
+				  __assume_kmalloc_alignment __alloc_size(1);
+
+static __always_inline __alloc_size(1) void *_kmalloc_flags_noprof(size_t size,
+		gfp_t flags, unsigned int alloc_flags, int node, kmalloc_token_t token)
+{
+	return __kmalloc_flags_noprof(PASS_TOKEN_PARAMS(size, token), flags, alloc_flags, node);
+}
+#define kmalloc_flags_noprof(...)	_kmalloc_flags_noprof(__VA_ARGS__, __kmalloc_token(__VA_ARGS__))
+#define kmalloc_flags(...)		alloc_hooks(kmalloc_flags_noprof(__VA_ARGS__))
+
 #ifdef CONFIG_64BIT
 # ifdef system_has_cmpxchg128
 # define system_has_freelist_aba()	system_has_cmpxchg128()
▲ 这段决定 API 形态:kmalloc_flags() 与普通 kmalloc() 唯一的差别是多一个 unsigned int alloc_flags 形参。它复用 alloc_hooks() 与 kmalloc_token 管线,因此 alloc-tag、KASAN 等公共记账对本 API 同样生效——新增入口不会绕过任何已有的安全/审计机制。
+/*
+ * The only version of kmalloc_node() that takes alloc_flags and thus can
+ * determine on its own whether to handle the allocation via kmalloc_nolock() or
+ * normally
+ */
+void *__kmalloc_flags_noprof(DECL_TOKEN_PARAMS(size, token), gfp_t flags,
+			     unsigned int alloc_flags, int node)
+{
+	const struct slab_alloc_context ac = {
+		.caller_addr = _RET_IP_,
+		.orig_size = size,
+		.alloc_flags = alloc_flags,
+	};
+
+	if (alloc_flags_allow_spinning(alloc_flags)) {
+		return __do_kmalloc_node(NULL, flags, node,
+				PASS_TOKEN_PARAM(token), &ac);
+	} else {
+		return __kmalloc_nolock_noprof(PASS_TOKEN_PARAMS(size, token),
+					       flags, node, &ac);
+	}
+}
▲ 这是机制成立的核心:alloc_flags_allow_spinning() 只看 alloc_flags 是否含 SLAB_ALLOC_NOLOCK。非自旋时交 __kmalloc_nolock_noprof()(trylock 拿不到 per-CPU 锁就失败返回,不阻塞);允许自旋时走 __do_kmalloc_node() 标准路径。两个分支共用同一个 slab_alloc_context,保证 orig_size / caller_addr / alloc_flags 在下游记账里完全一致。
📈 性能影响
alloc_flags 替代公共 GFP 标志位判断,把"是否防递归 / 是否免 obj_ext"的决策从稀缺的 gfp 标志计算中剥离,分配路径的选择更直接(alloc_flags_allow_spinning() 只是一个位测试)。次:off-CPU 锁等待——非自旋分支
__kmalloc_nolock_noprof() 用 trylock 获取 per-CPU sheaf 锁,拿不到立即失败返回而非阻塞自旋,避免了嵌套分配在已持锁上下文上的等待/死锁。按 Brendan Gregg 的 on-CPU vs off-CPU 视角,本补丁优化的是"分配时选路径"的判断成本(on-CPU),以及嵌套场景下的锁等待风险(off-CPU)。
kmalloc_nolock 路径)才能量化,本报告不编造数字。
🔄 方案演进
struct slab_alloc_context(203890bbd292)、引入 alloc_flags 与 SLAB_ALLOC_NOLOCK(74d224ac9288)、把 alloc_flags 逐层穿进 slab 分配钩子链(slab_post_alloc_hook() 链、__do_kmalloc_node() 等)。本补丁(patch 14)收口出 kmalloc_flags() 入口;随后两个补丁是消费它的迁移:
- patch 15 = 30222639602c《mm/slab: remove __GFP_NO_OBJ_EXT usage from alloc_slab_obj_exts()》——obj_ext 数组分配改用
kmalloc_flags()传SLAB_ALLOC_NO_RECURSE。 - patch 16 = 71553a606759《mm/slab: replace __GFP_NO_OBJ_EXT with SLAB_ALLOC_NO_RECURSE for sheaves》——sheaf 分配改用
kmalloc_flags(),并最终移除 slab 内对__GFP_NO_OBJ_EXT的全部使用(该标志只剩include/linux/gfp_types.h里的定义,mm/ 中无使用方)。 </ul> </div> </div></div>Review 驱动的修正(来自系列后续 commit message 的记录)patch 15 的 commit message 记录了 review 发现并已被解决的两个点:Hao Li 指出kmalloc_nolock()转用传入 gfp 后可能混入__GFP_THISNODE(机会性 slab 分配用),Shengming Hu 指出allocate_slab()可能混入__GFP_COMP——作者把两者都加入OBJCGS_CLEAR_MASK在分配 obj_ext/sheaf 时清除(commit 30222639602c)。这是系列里明确可见的 review→演进证据;本补丁及系列其余补丁均带Reviewed-by: Hao Li / Suren Baghdasaryan / Harry Yoo (Oracle)。
数据源说明:系列 v1 的讨论帖与各版 review 邮件未能从本环境 lore 索引拉取(lore MCP 对 20260610-slab_alloc_flags-v2-* 系列多次查询均未命中,curl 亦只返回 bot 挑战页)——上文的演进与 review 信息来自本地内核 git 的 commit message(Link: 标签 + 作者署名),是合入主线的权威记录。⚠️ 风险与局限
收益成立的前提收益只有在嵌套分配真正发生时才体现:per-CPU sheaf 耗尽需现场补给新容器、或启用 memcg/alloc_tag 使 obj_ext 数组分配变活跃。若分配速率低、per-CPU 容器从不耗尽、且未开记账,则两条嵌套路径基本不走,kmalloc_flags()近乎 no-op。此外非自旋分支的 trylock 语义是"拿不到锁就失败返回 NULL",调用方必须能接受分配失败并回退,否则会引入分配失败路径。生产落地影响纯内部 API:kmalloc_flags()在mm/slab.h(内部头文件)声明,不导出到模块/用户态,无 sysctl、无配置开关,升级到 Linux 7.2 即自动生效。依赖整个系列合入:单独取本补丁而缺 patch 15/16 时,两个调用方还没迁到kmalloc_flags(),入口无人使用;因此落地必须 16 补丁整体合入(主线 7.2 已做到)。运维可观测性无新增计数器。生态 / 兼容性对外部 kmalloc 用户零行为变化(外部调用不传 alloc_flags,走默认路径);_kmalloc_nolock_noprof()的对外签名与语义保持不变(只是内部实现拆成核心 + 薄包装)。副作用是系列把__GFP_NO_OBJ_EXT从 slab 内移除,标志定义仍保留在gfp_types.h(mm/ 内已无使用者),其它子系统的历史用法不受影响。对依赖kmalloc_nolock()的调用方(如 BPF local storage,见 7.1 的 5063e7758899),gfp 允许集合在系列后收窄为__GFP_ACCOUNT|__GFP_ZERO(+ 内部补的 NOWARN/NOMEMALLOC),语义更收紧。review 质疑(可追溯的已解决项)Hao Li(__GFP_THISNODE混入)与 Shengming Hu(__GFP_COMP混入)的质疑已在系列 patch 15(commit 30222639602c)通过扩充OBJCGS_CLEAR_MASK解决;三位 reviewer 的 Reviewed-by 贯穿本补丁与系列后续补丁。未发现针对本补丁的公开 NACK。lore 上的完整讨论串未能从本环境索引拉取(见"方案演进"数据源说明)。严重度:MINOR · 落地场景:风险极低的基础设施重构——唯一需留意的是"收益依赖系列整体 + 嵌套分配场景",以及非自旋分支 trylock 失败回退语义。🔗 交叉引用
📌 关联工作 / 系列其他补丁mm/slab: remove __GFP_NO_OBJ_EXT usage from alloc_slab_obj_exts()(系列 patch 15)——obj_ext 数组迁移到kmalloc_flags(),引入SLAB_ALLOC_NO_RECURSE
mm/slab: replace __GFP_NO_OBJ_EXT with SLAB_ALLOC_NO_RECURSE for sheaves(系列 patch 16)——sheaf 迁移 + 最终移除__GFP_NO_OBJ_EXT
系列 patch 15 lore Link / 系列 patch 16 lore Link
slab: don't assume alignment on allocators that may return ZERO_SIZE_PTR(RFC,2026-07)——同一分配路径上对齐假设的后续讨论
kmalloc_nolock()概念:见 bpf: Use kmalloc_nolock() universally in local storage(7.1)——BPF 本地存储全面改用非自旋分配的早期应用
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。