bpf:resizable hashtab 单字长 key 快路径内联 — 消除 jhash 间接派发
💡 一句话总结
在 eBPF 可扩容哈希表(BPF_MAP_TYPE_RHASH)的高频查找/更新/删除路径上,当 map 的 key 恰好是 4 或 8 字节(等于一个机器字长)时,把哈希与比较从“通用 jhash 哈希 + memcmp 比较的函数调用/派发”换成由 static const rhashtable_params 驱动的编译期内联 XOR-fold 哈希与单字相等比较,消除每次操作 jhash 间接派发的指令与调用开销;补丁未提供基准数据,收益为机制层面逻辑分析(解读(AI 分析))。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(performance)——bpf 哈希热路径消除函数调用/间接派发;兼有微重构性质(新增特化 params 并三处调用点切换) |
| 状态 | Merged · 已合入主线 Linux 7.2(v7.2-rc1 首个包含此 commit,经 bpf-next 合并,2026-06-17 合入,v7.2-rc1 于 2026-06-28 打标签;commit 日期 2026-06-05) |
| 当前版本 | v7 系列第 7/7 补丁 · lore 链接 |
| 版本演进 |
v1→v6(2026 上半年,未在 lore 索引中解析到具体日期)→ v7(2026-06-05,7 补丁完整系列) (v1→v6 逐版本演进/讨论未拉取:lore MCP 对 Message-ID 返回空/无关结果,见“方案演进”章节说明) |
| 作者机构 | Mykyta Yatsenko(yatsenko@meta.com,Meta);由 bpf 维护者 Alexei Starovoitov(ast@kernel.org)合入 |
| 提交日期 | 2026-06-05 08:00:08 -0700 |
| 改动范围 | kernel/bpf/hashtab.c,+45/-2(47 行),1 文件 |
| 核心函数 | rhtab_hashfn_long() / rhtab_key_cmp_long() / rhtab_lookup_elem() / rhtab_delete_elem() / rhtab_map_update_elem() / rhtab_map_alloc() |
| 原始链接 | git.kernel.org commit 9dcbb5045fe5 · lore Message-ID |
📊 速览卡片
特性等级依据:机制明确(热路径减函数调用/间接派发,编译器内联)、落地零门槛零回归(纯内核改动、key_size==sizeof(long) 自动生效、非目标 key 走原路径)、兼容性好(seq_file iterator 与一致性不受影响),但无基准数据、且仅覆盖单字长 key 一种形态 → ★★★★。
🎯 解决什么问题
BPF_MAP_TYPE_RHASH,底层用通用 rhashtable 实现,打破传统 htab 必须按 max_entries 预分配固定槽位的限制(系列 patch 4/7 commit message:“fixed-size htab is the only map supporting these field types”)。系列结构(v7 最终形态,7 补丁):① rhashtable 核心 API(
rhashtable_next_key())→ ② selftest → ③ rhashtable 用 irq work 收缩(Herbert Xu,NMI 安全自动收缩)→ ④ bpf 可扩容哈希表基本函数(主体:新 map 核心)→ ⑤ 迭代 ops(get_next_key / batch / seq_file iterator)→ ⑥ 特殊字段(timers / kptr / spin_lock / BPF_F_LOCK)→ ⑦ 本补丁:单字长 key 快路径优化(收尾优化层)。本补丁角色:系列的第 7 个补丁,是叠加在新 map 类型之上的纯性能优化层——不新增 API、不改变语义,只对已就绪的查找/更新/删除路径做 word-sized key 特化。依赖前置 patch ④提供的新 map 基础;与 ⑤ 的
rhashtable_next_key() / seq_file iterator 保持哈希一致性。
rhashtable_lookup_likely() 等 API 时,传的是通用 rhtab_params(hashfn、obj_cmpfn 均为空,key 长度运行时取自 ht->p.key_len)。rhashtable 内部 rht_key_get_hash() 在 key 长度/哈希函数不是编译期常量时,只能派发到 jhash2()/jhash()(多轮混合、~10+ 条 ALU + 一次真实函数调用),比较则回退到 rhashtable_compare() 即 memcmp()(又一次函数调用 + 逐字节循环)。对高频触发的 bpf map 操作,这两次调用与派发分支就是每次操作都要付的固定税。
关键点:rhashtable 的
rht_key_get_hash() / __rhashtable_lookup() 都是 __always_inline 且按值接收 struct rhashtable_params。只要传入的 params 是 static const(字段全是编译期常量),编译器就能在函数体内常量折叠——这正是本补丁的切入点。
为什么该场景遇到系统缺陷:数据平面每包做一次 map 操作,通用路径的 jhash 函数调用 + memcmp 调用虽然单次只有几十纳秒级开销,但在 10Mpps+ 的包速率下会被放大成可观的 CPU 占用;且这些 bpf 程序本身就是 on-CPU 密集计算,省掉每次操作的调用/派发直接转成可用的 CPU 预算。
🧩 核心机制
核心逻辑点只有一个:让编译器在编译期知道“key 是单字长、哈希是 XOR-fold、比较是单字相等”,从而把哈希与比较内联成几条指令,替代通用路径的 jhash/memcmp 函数调用与派发。
__always_inline 特化函数 + 一个 static const params 结构。
rhtab_hashfn_long() 只做一次 XOR 折叠:把 64 位 key 的高 32 位与低 32 位异或再异或 seed,约 3 条 ALU 指令;rhtab_key_cmp_long() 直接把 key 当 unsigned long 与元素内嵌 key 做一次 != 比较。两者都声明 __always_inline。rhtab_params_long 把这些函数指针、key_len = sizeof(long)、元素偏移固化成 static const 结构。
第 2 步:快路径调用点把
rhtab_params_long 传给 rhashtable API。
查找/删除/更新三处调用 rhashtable_lookup_likely() / rhashtable_remove_fast() / rhashtable_lookup_get_insert_fast() 时,若 map->key_size == sizeof(long) 就传 rhtab_params_long,否则走原 rhtab_params。由于这些 rhashtable API 是 __always_inline 且按值收 params,编译器把 rhtab_params_long 的常量字段(key_len/hashfn/obj_cmpfn)传播进 rht_key_get_hash() 与 __rhashtable_lookup(),把 XOR-fold 哈希与单字比较直接展开成内联指令——jhash2()/jhash() 与 memcmp() 的调用及派发被整体消除。
第 3 步:一致性的保证。同一组 hashfn/cmpfn 在
rhtab_map_alloc() 里装入本地 params 后传给 rhashtable_init(),即写入 rhashtable 存储的 ht->p。因此走存储 params 的 rehash worker、慢路径插入、rhashtable_next_key() 与内联快路径算出的哈希/比较结果完全一致。commit message 明确:seq_file BPF iterator 走 rhashtable_walk_*,不受本补丁影响。
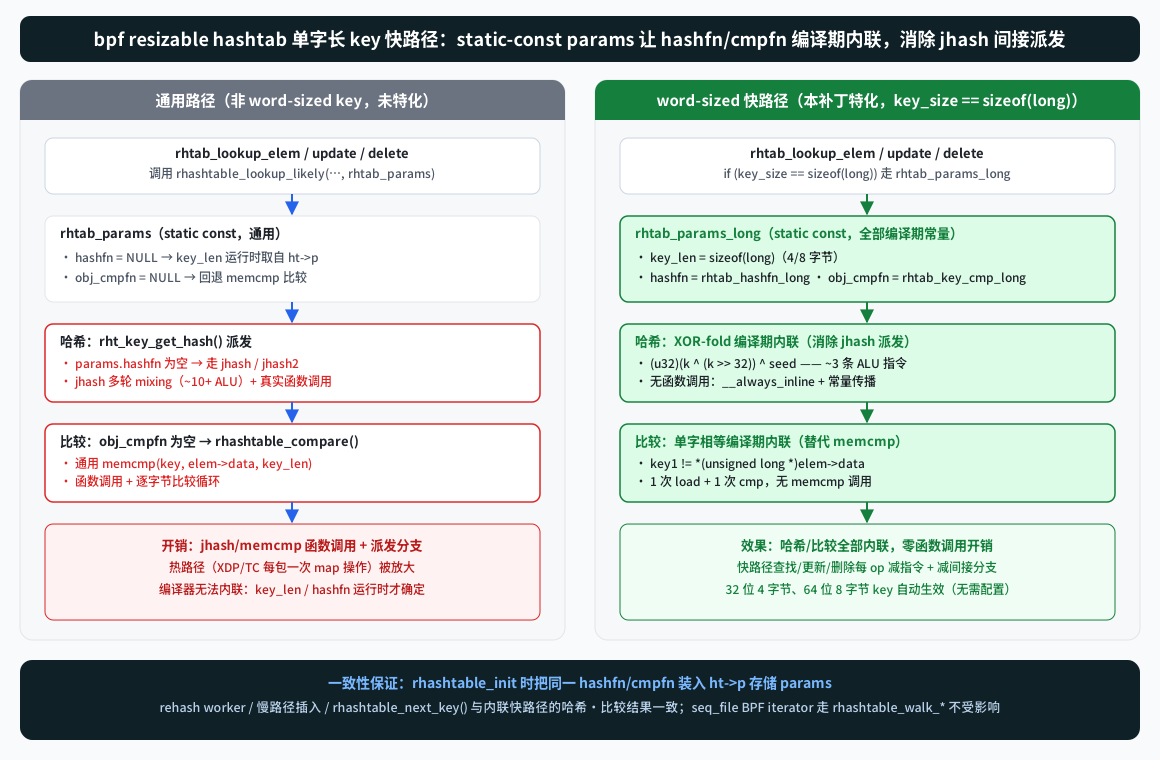
rhtab_params 的 hashfn/cmpfn 为空,哈希派发到 jhash2/jhash(函数调用)、比较回退 memcmp;右:rhtab_params_long 为 static-const,编译器内联 XOR-fold 哈希与单字相等比较,消除 jhash 间接派发;底部:同一 hashfn/cmpfn 在 rhashtable_init 时装入 ht->p,保证 rehash/慢路径/next_key 与快路径一致来源:基于本地内核 git commit 9dcbb5045fe5 真实 diff 绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 定义特化函数 | __always_inline rhtab_hashfn_long():(u32)(k ^ (k >> 32)) ^ seed | 64 位 key 一次 XOR 折叠成 32 位哈希,~3 条 ALU |
| 定义特化比较 | __always_inline rhtab_key_cmp_long():key1 != *(unsigned long *)key2->data | 单次 load + 比较,替代 memcmp 调用 |
| 固化常量 params | static const struct rhashtable_params rhtab_params_long | key_len/hashfn/obj_cmpfn 全部编译期常量 → 内联 |
| 三处调用点切换 | key_size == sizeof(long) 时传 rhtab_params_long | lookup/delete/update 快路径命中特化 |
| init 装入存储 params | rhashtable_init() 前设置 params.hashfn/obj_cmpfn | rehash/慢路径/next_key 与内联快路径哈希一致 |
+/* Specialize hash function and objcmp for long sized key */
+static __always_inline int rhtab_key_cmp_long(struct rhashtable_compare_arg *arg,
+					      const void *ptr)
+{
+	const unsigned long key1 = *(const unsigned long *)arg->key;
+	const struct rhtab_elem *key2 = ptr;
+
+	return key1 != *(const unsigned long *)key2->data;
+}
+
+static __always_inline u32 rhtab_hashfn_long(const void *data, u32 len, u32 seed)
+{
+	u64 k = *(const unsigned long *)data;
+
+	return (u32)(k ^ (k >> 32)) ^ seed;
+}
+
+static const struct rhashtable_params rhtab_params_long = {
+	.head_offset = offsetof(struct rhtab_elem, node),
+	.key_offset  = offsetof(struct rhtab_elem, data),
+	.key_len     = sizeof(long),
+	.hashfn      = rhtab_hashfn_long,
+	.obj_cmpfn   = rhtab_key_cmp_long,
+};
▲ 这段是机制成立的关键:__always_inline + static const 是“内联”的两个前提——哈希从 jhash 多轮混合退化为一次 k ^ (k >> 32) 折叠,比较从 memcmp 调用退化为一次单字 !=;且 key_len = sizeof(long) 是编译期常量,编译器据此走 __builtin_constant_p 的内联分支而不是 ht->p.hashfn 运行时派发。
if (rhtab->map.key_size == sizeof(long)) {
params.hashfn = rhtab_hashfn_long;
params.obj_cmpfn = rhtab_key_cmp_long;
}
err = rhashtable_init(&rhtab->ht, ¶ms);+ if (map->key_size == sizeof(long))
+ return rhashtable_lookup_likely(&rhtab->ht, key, rhtab_params_long);
+
return rhashtable_lookup_likely(&rhtab->ht, key, rhtab_params);
}▲ 这段说明“如何接线 + 如何保证一致性”:rhtab_map_alloc() 在 rhashtable_init() 前把同一组 hashfn/cmpfn 装入存储 params(rehash worker、慢路径插入、rhashtable_next_key() 都读这份),rhtab_lookup_elem() 则在 key 恰为单字长时把 rhtab_params_long 传给内联 API。删除/更新调用点(rhtab_delete_elem / rhtab_map_update_elem)用同一 if/else 模式切到 rhtab_params_long——这正是 commit message 里“the rehash worker, slow-path inserts, and rhashtable_next_key() all agree with the inlined fast paths”的落实。
📈 性能影响
从 Brendan Gregg 的 on-CPU vs off-CPU 视角:这是典型的 on-CPU 收益——省掉的是一次
jhash2()/jhash() 调用与 memcmp() 调用的调用约定开销、派发分支预测开销,以及 XOR-fold 相对 jhash 更少的 ALU 指令。
- eBPF 每包/每次事件 map 操作(XDP/TC/kprobe):数据平面每包查表,map 操作是循环内指令热区,减调用/派发直接降低每包 CPU 周期。
- 单字长 key 占比高的 map:IPv4 地址(u32)、五元组哈希(u64)、端口、计数 ID、指针——命中
key_size == sizeof(long)才走快路径;key 长于 8 字节的 map 无此收益(走原路径)。 - 64 位 vs 32 位:64 位平台上单字是 8 字节、32 位平台上是 4 字节,两端自动覆盖对应长度的单字 key。
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| (补丁未提供基准数据) | — | — | — |
说明:commit message 与补丁均未给出 benchmark 数字(无“作者自报”的量化提升),此补丁性能收益是机制层面逻辑分析(解读(AI 分析))——收益=消除每次操作 jhash/memcmp 的函数调用 + 间接派发 + 若干 ALU 指令,幅度取决于单次 map 操作中哈希/比较占比与该操作频率;具体数字需在真实 bpf 负载(如 XDP 转发 + 查表)上实测,本报告未进行。
🔄 方案演进
本补丁属于“bpf resizable hashmap”7 补丁系列的最后一个(v7-7)。v7 系列于 2026-06-05 提交,2026-06-17 经 bpf-next-7.2 合并进主线。系列从 rhashtable 核心 API 铺起,逐步构建出 BPF_MAP_TYPE_RHASH 新 map 类型,本补丁是其收尾的热路径优化层。
v7-2 rhashtable: Add selftest for rhashtable_next_key() → 测试覆盖。
v7-3 rhashtable: Use irq work for shrinking(Herbert Xu + Mykyta)→ 自动收缩改为 irq work,NMI 上下文安全。
v7-4 bpf: Implement resizable hashmap basic functions(系列主体)→
BPF_MAP_TYPE_RHASH 基本查找/更新/删除,bpf_mem_alloc 元素缓存。v7-5 bpf: Implement iteration ops for resizable hashtab → get_next_key / batch / seq_file BPF iterator。
v7-6 bpf: Allow special fields in resizable hashtab → timers / workqueue / spin_lock / kptr / BPF_F_LOCK。
v7-7 bpf: Optimize word-sized keys for resizable hashtable(本补丁)→ 单字长 key 快路径内联。
lore_message 精确 Message-ID、lore_series_timeline、按作者/主题检索)对 20260605-rhash-v7-7-5b8e05f8630d@meta.com 返回空结果或无关线程,因此 v1→v6 各版本的逐版改动要点、Alexei Starovoitov 等维护者的 review 意见,以及版本号从 1 走到 7 的驱动因素,本报告无法回溯。可确认的事实:本补丁由 Meta 工程师提交、经 Alexei Starovoitov 合入;v7 系列含 rhashtable 核心贡献者 Herbert Xu 的合作补丁(v7-3),说明该系列跨 rhashtable/bpf 两子系统、由 Meta 主导。
⚠️ 风险与局限
- key 长度前提:只有
map->key_size == sizeof(long)(64 位 8 字节 / 32 位 4 字节)才命中快路径;其他 key 长度走原rhtab_params路径,行为与性能不变(no-op)。 - 访问频率前提:收益来自每次操作省下的调用/派发,只有 map 操作足够高频(每包/每次事件)才可感知;低频操作收益可忽略。
- map 类型前提:本补丁只作用于新引入的
BPF_MAP_TYPE_RHASH;传统htab不受影响。
- 零配置自动生效:纯内核改动,无需 sysctl/编译开关;内核升级到 7.2 后,新建的
BPF_MAP_TYPE_RHASH单字长 key map 自动走快路径。 - 哈希分布变化需关注(解读(AI 分析),推测):XOR-fold 的混合质量弱于 jhash,对某些“低熵高 32 位”或“规律性”key 模式可能产生更多冲突,进而拉长桶链、放大比较次数;rhashtable 的
hash_rndseed 可抗 hash-flooding 攻击,但分布仍不如 jhash 均匀。对负载以随机 key 为主的生产场景影响小;对人为构造的畸形 key 需实测。
- seq_file BPF iterator 不受影响:走
rhashtable_walk_*,与快路径无耦合(commit message 明确)。 - 哈希/比较一致性由 rhashtable_init 保证:同一 hashfn/cmpfn 装入
ht->p,rehash worker、慢路径插入、rhashtable_next_key()与内联快路径结果一致,不会出现“快路径插、慢路径找不到”的不一致。 - 与 rhashtable 公共机制的耦合:本补丁依赖 rhashtable 的
__always_inline+ 按值传参的 API 形态;未来若 rhashtable 重构破坏该内联契约,快路径收益可能退化(仍是正确性等价,仅性能回归)。
🔗 交叉引用
[v7-5] bpf: Implement iteration ops for resizable hashtab — 迭代/批处理/seq_file iterator(本补丁保证与其哈希一致)。
[v7-6] bpf: Allow special fields in resizable hashtab — timers/kptr/spin_lock 字段支持。
[v7-3] rhashtable: Use irq work for shrinking — Herbert Xu 合作补丁,NMI 安全自动收缩。
本补丁 lore 原始链接(20260605-rhash-v7-7) — 系列 v7 第 7 补丁。
rhashtable(lib/rhashtable.c,Herbert Xu 维护)— 本补丁依赖的通用可扩容哈希表基础设施,
rht_key_get_hash()/__rhashtable_lookup() 的内联派发机制是优化切入点。BPF_MAP_TYPE_RHASH — 7.2 新增的 bpf 可扩容哈希表 map 类型,本补丁为其热路径收尾优化。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。