workqueue: add a per-cpu backend for unbound pwqs
💡 一句话总结
在 unbound 工作队列(workqueue,不绑定具体 CPU、可跨核执行的延迟工作队列)场景下,本补丁系列为它新增一个可选的"每-CPU 后端"——让本应被多个队列共享、worker 可在多核间自由迁移的 unbound 工作项,改为绑定到入队 CPU 的静态每-CPU 线程池上执行,从而为后续把"per-cpu"变成 unbound 队列的一种亲和性设置(动态 CPU 隔离)铺路。补丁系列自身是准备性重构、不改变任何现有行为(尚无 workqueue 设置新标志),作者未提供基准数据。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 重构(为"每-CPU 后端"新特性做铺垫;系列自述 no functional change) |
| 状态 | In Review(2026-07-31 首版提交,等待维护者反馈) |
| 当前版本 | v1 · cover letter · 补丁 5/6 |
| 版本演进 | 首版,暂无演进 |
| 作者机构 | Breno Leitao (Debian) |
| 提交日期 | 2026-07-31 |
| 改动范围 | 全系列:include/linux/workqueue.h + kernel/workqueue.c,2 文件 +105/-39焦点补丁 5/6(每-CPU 后端):2 文件 +34/-0;补丁 6/6(创建时安装):1 文件 +6/-0 |
| 核心函数 | alloc_percpu_pwq() / unbound_wq_update_pwq() / get_percpu_pool() / is_pool_cpu_specific() / alloc_and_link_pwqs() |
| 原始链接 | lore cover letter Message-ID |
📊 速览卡片
注:本系列作者自述"changes no behaviour on its own",未提供基准数据;"每-CPU 后端"需后续补丁启用。
🎯 解决什么问题
WQ_PERCPU,工作项钉在入队 CPU 上执行,适合高局部性、低延迟的场景)和 unbound 工作队列(WQ_UNBOUND,不绑定 CPU,适合不关心在哪执行、可跨核调度的工作)。两者后端完全不同:per-cpu 用每-CPU 静态线程池,unbound 用按属性共享的"通用"线程池。这套"两套后端"的设计在 CPU 隔离场景下暴露了痛点。为什么需要合并:当通过 isolcpus / cgroup 隔离分区把一个 CPU 隔离出去(不让普通任务/中断打扰实时任务)时,原本钉在该 CPU 上的 per-cpu 工作队列工作项会继续执行,破坏隔离。理想做法是"动态"把这些工作项挪到非隔离 CPU 上执行。但 per-cpu 与 unbound 两套后端不互通,无法动态切换。
谁提出方向:workqueue 维护者 Tejun Heo 在 2026-07-08 回复 Marco Crivellari 的 RFC(ak569WYSm3ygKl1-@slm.duckdns.org)时明确建议:"merge percpu and unbound workqueues... If we make the pwqs be able to point to both unbound and percpu pools, the dynamic switch falls out naturally and percpu just becomes one of the affinity settings."(合并 per-cpu 与 unbound 工作队列;让 pwq 既能指向 unbound 池也能指向 per-cpu 池,动态切换自然出现,per-cpu 只是亲和性设置之一)。
本系列的角色:Breno 的 cover letter 复述这一目标——"so an unbound workqueue can run on the concurrency-managed per-cpu pools and WQ_PERCPU just requests that backend",并声明本系列只是准备性工作。
workqueue_struct,对外可见的队列)不直接持有 worker 线程,而是通过 pool_workqueue(pwq,中继结构)把工作项投递给 worker_pool(pool,实际的一组 worker 内核线程)。当前 unbound 工作队列的每个 pwq 都指向"专用 unbound pool"——该池按属性(attrs)从 unbound_pool_hash 哈希表查找/创建,属性相同的多个 WQ 共享同一个池,池带引用计数(引用归零才销毁),worker 不绑定任何 CPU(pool->cpu < 0)。问题链条:要让"unbound WQ 的 pwq 挂到 per-cpu pool"(
pool->cpu >= 0,静态、永不释放)成为可能,代码里有两处写死了"unbound ⇒ unbound pool"的假设:
- 池释放路径:
pwq_release_workfn()用wq->flags & WQ_UNBOUND判断是否调用put_unbound_pool()释放池。可 unbound pool 是"引用计数、用后销毁",per-cpu pool 是"永久存在、不能 put"——用 WQ 类型标志判断是错的,应该看池本身类型。 - 并发节流(nr_active)记账:unbound WQ 的 max_active(同时执行的工作项上限)按 NUMA 节点共享记账(
wq_node_nr_active),per-cpu WQ 则每 pwq 独立记账(pwq->nr_active < max_active)。现有代码用"有没有wq_node_nr_active"来区分,一旦 unbound pwq 挂了 per-cpu pool,这个判断就不对了。
为什么此场景会遇到系统缺陷:当工作项访问的数据与"入队 CPU"有亲和性(比如刚在 CPU0 上由某任务生产、随即排队的工作项),unbound pool 把它调度到别的 CPU/节点执行时,缓存里的热点数据不在执行 CPU 上,首次访问必须从内存重新加载;多个 WQ 共享同一 unbound pool 时,池内 worker 会被不同 WQ 的工作项互相挤占,带来池间切换与争用。
本系列的解法:新增
__WQ_PERCPU_POOLS 标志后,这类"入队 CPU 与数据强相关"的 unbound WQ 可选择每-CPU 后端——工作项钉在入队 CPU 的静态 per-cpu pool 上执行,数据热点留在本地缓存,也不与别的 WQ 共享池。
🧩 核心机制
本系列用三步把"unbound WQ 的 pwq 也能挂到 per-cpu pool"变为可能:先把"释放/节流"的判断从 WQ 类型标志改成 backing pool 类型(补丁 3/4),再新增每-CPU 后端与内部标志(补丁 5),最后在创建时就安装好(补丁 6)。
kernel/workqueue.c(外加 include/linux/workqueue.h 加一个标志位)。改动链条:
- 补丁 3:新增
is_pool_cpu_specific(pool)(返回pool->cpu >= 0),把pwq_release_workfn()、put_unbound_pool()、pool_allowed_cpus()、看门狗里的pool->cpu < 0/WQ_UNBOUND判断统一换成按池类型判断。这样"unbound WQ + per-cpu pool"的 pwq 释放时不会错误地去 put 一个永久的 per-cpu 池。 - 补丁 4:
pwq_tryinc_nr_active()/pwq_dec_nr_active()用is_pool_cpu_specific(pool)决定走"每 pwq 独立 nr_active"还是"按节点共享 nr_active"。per-cpu pool 并发度由每 CPU 的 pool 管理,每 pwq 对wq->max_active记账即可。 - 补丁 5:新增内部标志
__WQ_PERCPU_POOLS(bit 20)与alloc_percpu_pwq()——后者用get_percpu_pool(wq, cpu)拿到该 CPU 的静态 per-cpu pool(普通/高优先级二选一),创建指向它的 pwq。在unbound_wq_update_pwq()里,若 WQ 设置该标志,就为这个 CPU 安装 per-cpu 后端的 pwq,跳过原本的 pod 亲和性计算。 - 补丁 6:
alloc_and_link_pwqs()(WQ 创建时被调用)里,若设置该标志,对所有possible_cpu跑一遍unbound_wq_update_pwq(),让后端在 WQ 投入使用前就位,而不是等第一次 CPU 热插拔才装。
为什么要这么改 / 解决什么技术问题:技术难点不在"建一个 per-cpu pwq"(
init_pwq(pwq, wq, pool) 本来就接受任意 pool),而在"unbound 的安装/释放/节流路径假设池是 unbound 的"。补丁 3/4 先把这三个假设按池类型解耦,补丁 5 才能安全地把 per-cpu 池塞进 unbound 安装路径——install_unbound_pwq() 的 install/drain 机制原样复用,旧 pwq 照常排空,只是新 pwq 指向 per-cpu 池。为什么支撑场景提升(解读(AI 分析)):启用后,工作项钉在入队 CPU 的 per-cpu pool 上——执行 CPU 与数据热点 CPU 重合,省掉跨核/跨 NUMA 迁移与缓存重载;不再与其他 WQ 共享 unbound pool,消除池内互相挤占。
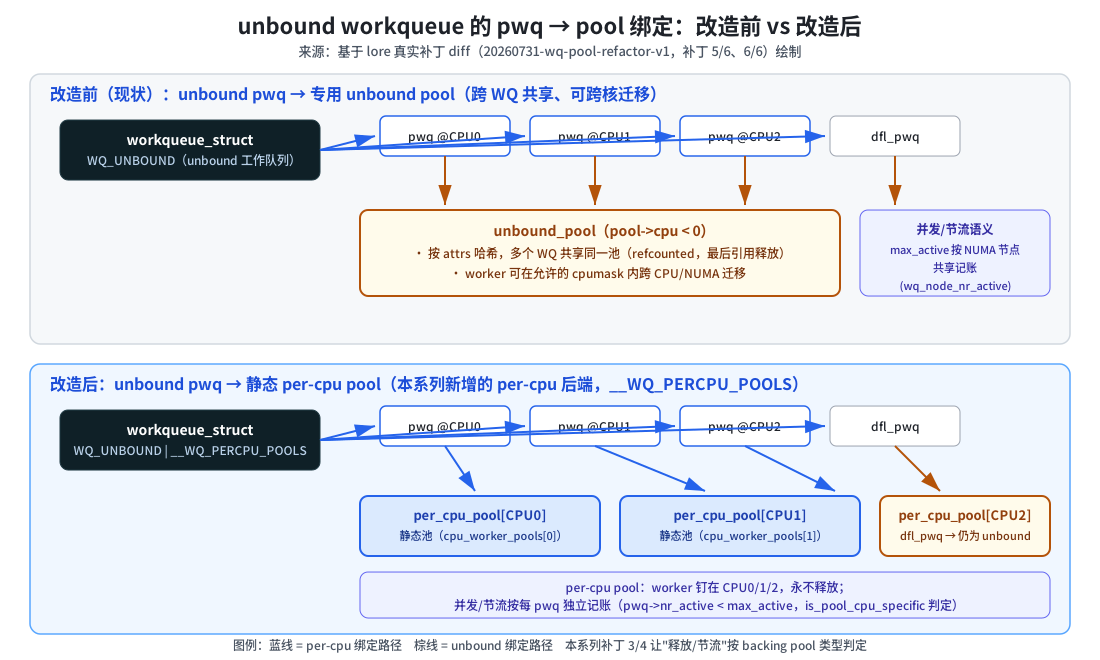
来源:基于 lore 真实补丁 diff(20260731-wq-pool-refactor-v1)绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 1. 池类型判定 | is_pool_cpu_specific(pool) = (pool->cpu >= 0),替换释放路径的 WQ_UNBOUND 判断(补丁 3) | unbound pwq 挂 per-cpu 池时,释放不误 put 永久池 |
| 2. 节流记账 | nr_active 增/减按池类型分流:per-cpu 池走每 pwq,unbound 池走每节点(补丁 4) | per-cpu 后端保持每 pwq 独立 max_active 语义 |
| 3. 每-CPU 后端 | alloc_percpu_pwq() 用 get_percpu_pool(wq, cpu) 建 pwq;unbound_wq_update_pwq() 遇 __WQ_PERCPU_POOLS 走此路径(补丁 5) | 让 unbound 安装路径可挂 per-cpu 池 |
| 4. 创建时安装 | alloc_and_link_pwqs() 对 for_each_possible_cpu 跑 unbound_wq_update_pwq()(补丁 6) | 后端在 WQ 使用前就位,不等首次热插拔 |
🔬 关键代码
前提(补丁 3/6):释放路径从"看 WQ 类型标志"改为"看 backing pool 类型"。这一行是后面所有改动的前提——没有它,unbound pwq 一旦挂上 per-cpu 池,释放时会错误地把永久池当成引用计数池销毁。
+/* True if @pool is tied to a specific CPU, rather than an unbound pool. */
+static bool is_pool_cpu_specific(struct worker_pool *pool)
+{
+	return pool->cpu >= 0;
+}
+
 ...
-	if (wq->flags & WQ_UNBOUND) {
+	if (!is_pool_cpu_specific(pool)) {
 		mutex_lock(&wq_pool_mutex);
 		put_unbound_pool(pool);
 		mutex_unlock(&wq_pool_mutex);
▲ 补丁 3/6:is_pool_cpu_specific() 判定"池是否钉在某个 CPU"。per-cpu 池的 pool->cpu >= 0(永久存在,不能 put);unbound 池 pool->cpu < 0(引用计数,最后引用释放时销毁)。释放判断不再依赖 WQ 是 per-cpu 还是 unbound,而看它实际挂的池。
核心(补丁 5/6):新增每-CPU 后端与内部标志,并在 unbound 安装路径里分流。
diff --git a/include/linux/workqueue.h b/include/linux/workqueue.h
index a283766a192aa..5bbbed94d2fa6 100644
--- a/include/linux/workqueue.h
+++ b/include/linux/workqueue.h
@@ -410,6 +410,7 @@ enum wq_flags {
 	__WQ_ORDERED		= 1 << 17, /* internal: workqueue is ordered */
 	__WQ_LEGACY		= 1 << 18, /* internal: create*_workqueue() */
 	__WQ_DEPRECATED		= 1 << 19, /* internal: workqueue is deprecated */
+	__WQ_PERCPU_POOLS	= 1 << 20, /* internal: back unbound pwqs with percpu pools */

 	/* BH wq only allows the following flags */
 	__WQ_BH_ALLOWS		= WQ_BH | WQ_HIGHPRI | WQ_PERCPU,
▲ 补丁 5/6:内部标志 __WQ_PERCPU_POOLS(bit 20,注释明说"用 per-cpu 池来背书 unbound pwq")。注意这是 __WQ_ 前缀的内部标志,不是用户可见的 WQ_* API。
+/*
+ * Create a pwq backing @wq on @cpu with the static per-cpu pool instead of a
+ * dedicated unbound pool. Used by the unbound pwq machinery for a workqueue
+ * that requests the per-cpu backend.
+ */
+static struct pool_workqueue *alloc_percpu_pwq(struct workqueue_struct *wq,
+					       int cpu)
+{
+	struct worker_pool *pool = get_percpu_pool(wq, cpu);
+	struct pool_workqueue *pwq;
+
+	lockdep_assert_held(&wq_pool_mutex);
+
+	pwq = kmem_cache_alloc_node(pwq_cache, GFP_KERNEL, pool->node);
+	if (!pwq)
+		return NULL;
+
+	init_pwq(pwq, wq, pool);
+	return pwq;
+}
+
▲ 补丁 5/6:alloc_percpu_pwq() 与 alloc_unbound_pwq() 的唯一差别是 pool 来源——前者用 get_percpu_pool(wq, cpu)(本系列补丁 1 从创建路径抽出的辅助函数,返回 cpu_worker_pools[cpu][highpri]),后者用 get_unbound_pool(attrs)。pwq 本身只是"wq 与 pool 之间的中继",init_pwq() 对两种池一视同仁。
@@ -5643,6 +5664,17 @@ static void unbound_wq_update_pwq(struct workqueue_struct *wq, int cpu)
 	if (!(wq->flags & WQ_UNBOUND) || wq->unbound_attrs->ordered)
 		return;

+	if (wq->flags & __WQ_PERCPU_POOLS) {
+		/* nothing to do if @cpu is already backed by its per-cpu pool */
+		if (is_pool_cpu_specific(unbound_pwq(wq, cpu)->pool))
+			return;
+
+		pwq = alloc_percpu_pwq(wq, cpu);
+		if (!pwq)
+			goto use_dfl_pwq;
+		goto install;
+	}
+
 	/*
 	 * We don't wanna alloc/free wq_attrs for each wq for each CPU.
 	 * Let's use a preallocated one.  The following buf is protected by
@@ -5666,6 +5698,7 @@ static void unbound_wq_update_pwq(struct workqueue_struct *wq, int cpu)
 		goto use_dfl_pwq;
 	}

+install:
 	/* Install the new pwq. */
 	mutex_lock(&wq->mutex);
 	old_pwq = install_unbound_pwq(wq, cpu, pwq);
▲ 补丁 5/6:unbound_wq_update_pwq() 里对 __WQ_PERCPU_POOLS 分流——已挂 per-cpu 池则直接返回,否则用 alloc_percpu_pwq() 建池后 goto install 复用公共安装路径。作者在 commit message 里自问这段用 goto label 而非 if/else 是否更好(见 💬 讨论焦点)。ordered 队列仍被排除(有序队列必须串行,语义不同)。
diff --git a/kernel/workqueue.c b/kernel/workqueue.c
index df4fc9ccb7b22..cd3d0d54dfddc 100644
--- a/kernel/workqueue.c
+++ b/kernel/workqueue.c
@@ -5766,6 +5766,12 @@ static int alloc_and_link_pwqs(struct workqueue_struct *wq)

 	if (ret)
 		goto enomem;
+
+	if (wq->flags & __WQ_PERCPU_POOLS) {
+		for_each_possible_cpu(cpu)
+			unbound_wq_update_pwq(wq, cpu);
+	}
+
 	return 0;

 enomem:
▲ 补丁 6/6:WQ 创建路径 alloc_and_link_pwqs() 里,若设标志就对所有 possible CPU 跑一遍 unbound_wq_update_pwq()——否则后端要等第一次 CPU 热插拔事件才装上,WQ 一创建就会被错误地当普通 unbound 使用。作者注明"尚无 workqueue 设置该标志,无功能变化"。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| (本系列无行为变化) | — | — | — |
说明:补丁未提供基准数据。作者在 cover letter 与补丁 6 commit message 中明确自述本系列 "changes no behaviour on its own"、"No workqueue sets __WQ_PERCPU_POOLS yet, so there is no functional change"。因此不存在可测量的改进/回退数字。
__WQ_PERCPU_POOLS,按机制推演(非实测):on-CPU 环节:减少 worker 跨 CPU/NUMA 迁移的调度开销;工作项在入队 CPU 本地执行,减少上下文/缓存切换。
off-CPU 环节:工作项访问的数据热点在入队 CPU 缓存,无需跨核重载,减少缓存未命中等待;不再与其他 unbound WQ 共享同一 pool,消除池内互相挤占导致的排队等待。
前提条件:这些收益依赖"工作项与入队 CPU 有数据亲和性"——若工作项本身无局部性、或负载在所有 CPU 均匀分布,每-CPU 后端收益有限甚至可能因失去共享池的负载均衡而略有回退。作者未提供任何 on/off-CPU 或场景化数据,以上为逻辑推演。
💬 讨论焦点
lore_eq(in_reply_to, cover letter) 只返回系列自身 6 个补丁,无外部回复。状态仍为待 review。
goto install 跳标签的写法是否比 if/else 分支更清晰,主动请 reviewers 拍板。这属于代码风格层面的开放问题,不影响功能正确性。
🔗 交叉引用
[PATCH 5/6] workqueue: add a per-cpu backend for unbound pwqs — 本报告主分析对象(+34/-0)
[PATCH 6/6] workqueue: install per-cpu pwqs at creation for __WQ_PERCPU_POOLS — 创建时安装后端(+6/-0)
⚠️ 风险与局限
is_pool_cpu_specific() 等价的替换 pool->cpu 判断、__WQ_PERCPU_POOLS 无任何 WQ 设置。理论上对所有现有 WQ 是 no-op。后续启用时的风险(解读(AI 分析)):
- CPU 隔离目标被违背:每-CPU 后端会把工作项钉在入队 CPU,若该 CPU 被隔离(isolcpus/cgroup),工作项反而被钉在隔离核上。这正是作者计划"动态切换"的原因,但本系列未实现——需要后续补丁。
- 共享池语义变化:per-cpu pool 每 CPU 仅普通/高优先级两个标准池,多个启用该后端的 WQ 会共享同一 per-cpu pool,池内工作项互相挤占——失去 unbound 专用池的隔离性。
- nr_active 语义变化:unbound 从"按 NUMA 节点共享 max_active"改为"每 pwq 独立"(补丁 4 已按池类型分流),同一 WQ 在不同 CPU 上的并发上限语义改变,需在真实多节点负载下验证节流行为是否符合预期。
- 生命周期/时序:per-cpu pool 永久存在,per-cpu 后端 pwq 的安装/排空复用
install_unbound_pwq()的 drain 机制,但 CPU 热插拔时 per-cpu pool 与 worker 的在线/离线交互需仔细验证。
失败模式:若
alloc_percpu_pwq() 分配失败,补丁 5 走 use_dfl_pwq 兜底(退回默认 unbound pwq),行为安全但可能瞬时偏离预期后端。
✅ 关键洞察
- 发现:本系列把"pwq 释放 / nr_active 记账"的判断从 WQ 类型标志改为 backing pool 类型(
is_pool_cpu_specific),让"unbound WQ 挂 per-cpu pool"在机制上成为可能;补丁 5/6 落地了可选的每-CPU 后端(__WQ_PERCPU_POOLS),为 per-cpu/unbound 合并铺路。 - 证据:作者自述无功能变化、无基准数据;方向来自 Tejun Heo 关于动态 CPU 隔离的建议(ak569WYSm3ygKl1-@slm.duckdns.org)。
- 边界:尚无任何 WQ 设置
__WQ_PERCPU_POOLS;仅 unbound 且非 ordered 的 WQ 受影响;dfl_pwq 保持 unbound;per-cpu 后端每 CPU 复用标准 per-cpu 池。 - 风险 / 建议:待维护者 review 确认方向(作者自问"Am I on the right path?");后续需解决动态切换(隔离 CPU 上挪走工作项)、共享 per-cpu 池的干扰、以及 per-pwq nr_active 语义在多节点负载下的验证;补丁 5 的 goto vs if/else 风格待定。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。