preempt/irq:NMI 嵌套计数迁出 + 中断重调度热路径优化
💡 一句话总结
在 NMI 与中断开关高频进出 preempt_count 的处理器热路径上,preempt_count 位域紧张(NMI 嵌套计数占 4 bit),每次 NMI 进出都要操作共享计数器、中断开关最外层解锁还要重读一次 preempt_count:本系列把 NMI 嵌套深度迁到独立的 per-CPU 计数器 nmi_nesting(NMI 位域从 4 bit 缩为 1 bit 标志),并让 local_interrupt_enable() 复用 hardirq_disable_exit() 的返回值、省掉一次 preempt_count 内存重读,从而为新的 Rust 计数式中断开关 SpinLockIrq 腾出位域并精简中断开关热路径。补丁未提供基准数据,收益为机制层面的逻辑分析(解读(AI 分析))。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能重构:位域腾挪 + 热路径减读)为主,兼有“新特性”性质(为 Rust 计数式中断开关铺路) |
| 状态 | In Review(作为 git pull request 提交给 tip 树;其中 irq 优化补丁已被作者撤回) |
| 当前版本 | 本 pull request 提交于 2026-07-31(rust-sync.20260731a)· cover letter 链接 |
| 版本演进 |
NMI 补丁:Lyude v17(2026-01-21) → 本 pull 01/24(2026-07-31) irq 补丁:Boqun v3(2026-06-05) → 本 pull 13/24(2026-07-31) → 2026-08-03 撤回 |
| 作者机构 | Boqun Feng(kernel.org / rust-for-linux 维护者);NMI 补丁原作者 Joel Fernandes(NVIDIA)、Lyude Paul(Red Hat) |
| 提交日期 | 2026-07-31(系列 24 补丁,41 文件,+1184/-121) |
| 改动范围 | NMI 补丁:include/linux/hardirq.h / preempt.h / kernel/softirq.c / BPF selftest,4 文件 +23/-7;irq 补丁:arm64/s390/x86/asm-generic preempt.h + interrupt_rc.h,5 文件 +32/-23 |
| 核心函数 | __nmi_enter() / __nmi_exit() / local_interrupt_enable() / hardirq_disable_exit() / __preempt_count_add_return() |
| 原始链接 | cover letter Message-ID · NMI 补丁 · irq 补丁 |
📊 速览卡片
🎯 解决什么问题
SpinLockIrq:C 语言里 spin_lock_irqsave() 需要调用方手动保存/恢复中断标志 flags,容易漏配对;Rust 的 RAII guard 希望在 drop() 时自动恢复中断状态。方案是把“中断禁用的嵌套层级”记进 preempt_count(即“计数式中断开关” local_interrupt_disable()/enable()),这样最外层退出临界区时自动恢复。
cover letter 原话:“The major changes are the introduction of preempt_count backed interrupt disabling level tracking, i.e. the local_interrupt_{enable, disable}(), along with the user (the Rust SpinLockIrq). This should unblock a few drivers in Rust.”(来源:cover letter)
但
preempt_count 只有 32 bit,已被 preempt(8)+softirq(8)+hardirq(4)+NMI(4)+NEED_RESCHED(1) 占掉 25 bit。要容纳新的硬中断禁用计数位,必须先压缩 NMI 位域——这就是 NMI 补丁的直接动因(推断为:位域腾挪,来自 cover letter 所述目的 + diff 中“free up the NMI bits…allowing those bits to be repurposed for other uses”)。
preempt_count 是一个 32 位、每线程(thread_info 或 lowcore)的整型,用位域同时承载“可抢占深度、软中断深度、硬中断深度、NMI 嵌套深度、是否需要重调度”。NMI 嵌套用 4 bit(NMI_MASK=0x00f00000,最多 15 层),而现实中 NMI 嵌套几乎不会超过 1–2 层,4 bit 明显冗余;但它把位域撑满,导致无法再放入新的计数字段(如 HARDIRQ_DISABLE)。NMI 进出本应是最“轻”的路径,却要和硬中断、软中断、抢占深度挤在同一变量上做加减。
缺陷 2(irq 补丁解决):计数式中断开关最外层解锁
local_interrupt_enable() 时,hardirq_disable_exit() 刚返回了递减后的 preempt_count 新值;但原代码仍调用 should_resched(0),后者内部重新 READ_ONCE(preempt_count) 从内存再读一次同一变量。commit message 里留有 TODO:“re-read preempt count can be avoided”(本次把它做掉)。
spin_lock_irqsave()/spin_unlock_irqrestore() 家族)。改造后新增的 spin_lock_irq_disable()/spin_unlock_irq_enable()(patch 05/24 引入)在每次 lock/unlock 都走 local_interrupt_disable()/enable(),即 __preempt_count_add_return()/__preempt_count_sub_return()——这条路径的频率与自旋锁一样高(驱动、内核同步到处都是)。
NMI 路径(
__nmi_enter()/__nmi_exit())是处理器最高优先级异常入口/出口,任何 perf、watchdog、硬件错误处理都会触发;在 NMI 下内核原则上“不吃锁、不调度”,要求进出尽可能廉价。把 NMI 嵌套计数从共享的 preempt_count 位域搬到独立 per-CPU 计数器,既腾出位域,也让 NMI 嵌套与硬/软中断计数解耦。
Rust 侧场景:即将接入的若干驱动(cover letter 提到 “unblock a few drivers in Rust”,具体驱动未列出,属推断)会使用
SpinLockIrq,其 guard 的 drop 走 spin_unlock_irq_enable() → local_interrupt_enable()。
🧩 核心机制
两个补丁解决两个不同的“热路径/位域”问题:NMI 补丁把嵌套计数迁到 per-CPU 变量、把 NMI 位域从 4 bit 压到 1 bit 标志;irq 补丁让中断开关最外层解锁直接复用已有的返回计数,省一次 preempt_count 内存读。前者是后者的前提——只有把 NMI 位域从 4 bit 压到 1 bit 标志,才能连同原 HARDIRQ 位域一起重新组织出 8 bit 的 HARDIRQ_DISABLE 计数字段(patch 02/24 引入)。
DEFINE_PER_CPU(unsigned int, nmi_nesting)(在 kernel/softirq.c)。__nmi_enter() 里 __this_cpu_inc(nmi_nesting)(上限 15),再 __preempt_count_add(HARDIRQ_OFFSET) 保持“硬中断计数”语义,并用 preempt_count_set(preempt_count() | NMI_MASK) 置上唯一的 NMI 标志位;__nmi_exit() 反向:先 __preempt_count_sub(HARDIRQ_OFFSET),__this_cpu_dec_return(nmi_nesting) 到 0 才用 preempt_count_set(preempt_count() & ~NMI_MASK) 清标志。为什么这么改:嵌套深度不再占用 preempt_count 的 4 bit,只留 1 bit“是否在 NMI 中”的布尔标志,in_nmi() 语义保持不变,腾出的位域(连同原 HARDIRQ 位域)在 patch 02/24 中被重新组织为 8 bit 的 HARDIRQ_DISABLE 计数字段。
irq 补丁(13/24):把
__preempt_count_{add,sub}_return() 的返回类型从 int 改为 unsigned long(arm64 上从读 u32 preempt.count 改为读 64 位 preempt_count),使其返回完整位域(含 bit31 的 PREEMPT_NEED_RESCHED)。新增 local_interrupt_enable_reched(pc):pc 非 0(仍在某些禁用上下文)则直接返回;为 0 且架构无 PREEMPT_NEED_RESCHED 位时先查 tif_need_resched(),否则直接 __preempt_schedule()。这样 local_interrupt_enable() 用 hardirq_disable_exit() 的返回值即可完成“是否需要重调度”的判断,不再重读 preempt_count。
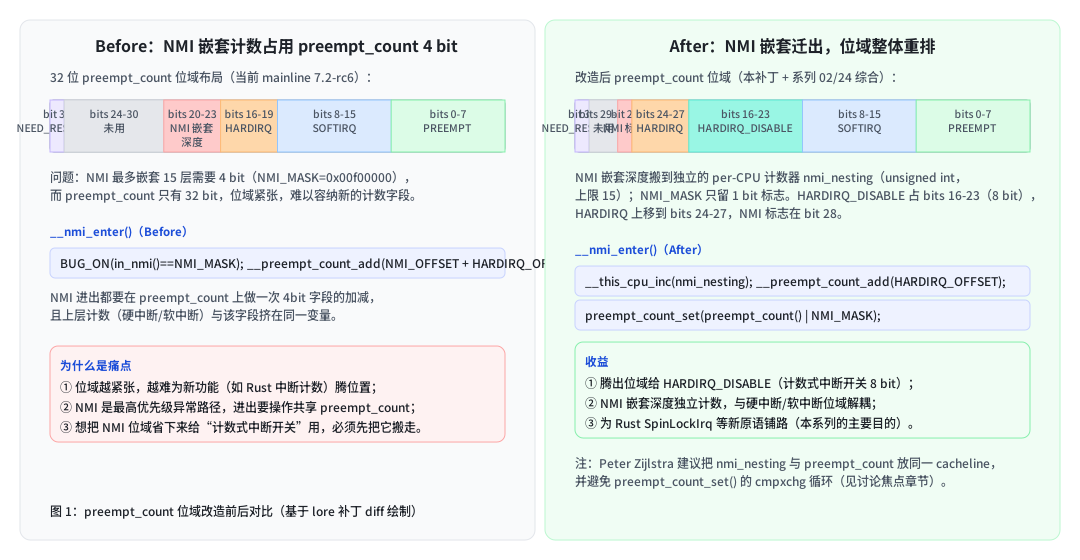
来源:基于 lore 真实补丁 diff(PATCH 01/24)绘制
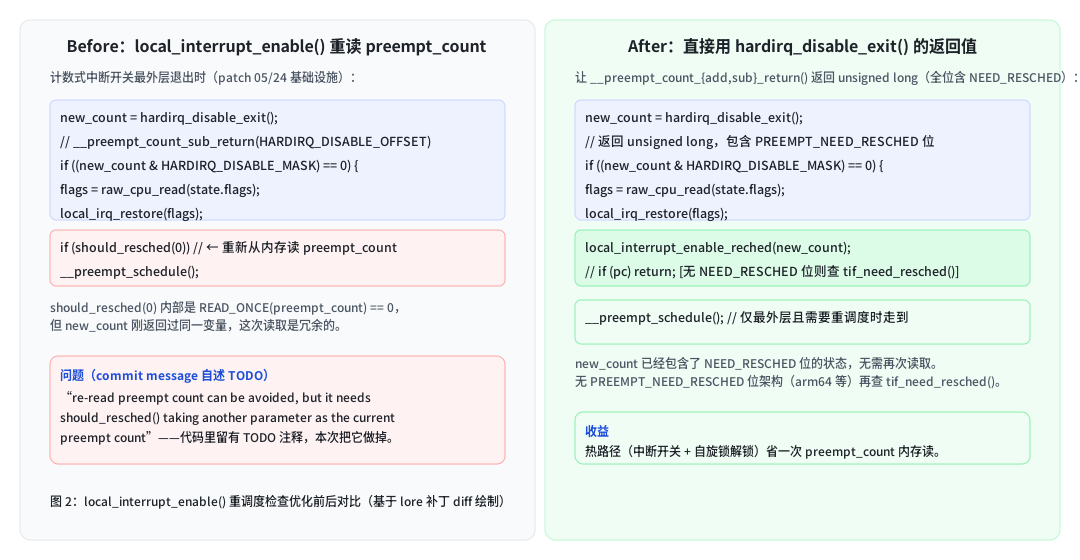
来源:基于 lore 真实补丁 diff(PATCH 13/24)绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| NMI 进入 | __this_cpu_inc(nmi_nesting) + __preempt_count_add(HARDIRQ_OFFSET) + preempt_count_set(preempt_count() | NMI_MASK) | 嵌套深度记到 per-CPU 计数器;preempt_count 只留 1 bit NMI 标志 + 硬中断计数 |
| NMI 退出 | __preempt_count_sub(HARDIRQ_OFFSET) + __this_cpu_dec_return(nmi_nesting),归 0 才清 NMI_MASK | 只有最外层 NMI 退出才清除“在 NMI 中”标志,保持 in_nmi() 语义 |
| 中断开关解锁 | new_count = hardirq_disable_exit()(返回 unsigned long 全位域) | 把 NEED_RESCHED 位一并返回,避免再读一次 preempt_count |
| 重调度判断 | local_interrupt_enable_reched(new_count):pc 为 0 且需要重调度才 __preempt_schedule() | 最外层且确实需要重调度时才走慢路径 |
🔬 关键代码
以下 diff 为 lore 中补丁的逐字原文。核心逻辑点有两个:① NMI 嵌套计数迁出 + 位域压缩;② 中断开关解锁复用返回计数。
逻辑点 1:NMI 嵌套计数迁出(补丁 01/24)
diff --git a/include/linux/hardirq.h b/include/linux/hardirq.h
index d57cab4d4c06..8d4895531a45 100644
--- a/include/linux/hardirq.h
+++ b/include/linux/hardirq.h
@@ -10,6 +10,8 @@
 #include <linux/vtime.h>
 #include <asm/hardirq.h>

+DECLARE_PER_CPU(unsigned int, nmi_nesting);
+
 extern void synchronize_irq(unsigned int irq);
 extern bool synchronize_hardirq(unsigned int irq);

@@ -102,14 +104,17 @@ void irq_exit_rcu(void);
  */

 /*
- * nmi_enter() can nest up to 15 times; see NMI_BITS.
+ * nmi_enter() can nest - nesting is tracked in a per-CPU counter.
  */
 #define __nmi_enter()						\
 	do {							\
 		lockdep_off();					\
 		arch_nmi_enter();				\
-		BUG_ON(in_nmi() == NMI_MASK);			\
-		__preempt_count_add(NMI_OFFSET + HARDIRQ_OFFSET);	\
+		/* Maximum NMI nesting is 15. */		\
+		BUG_ON(__this_cpu_read(nmi_nesting) >= 15);	\
+		__this_cpu_inc(nmi_nesting);			\
+		__preempt_count_add(HARDIRQ_OFFSET);		\
+		preempt_count_set(preempt_count() | NMI_MASK);	\
 	} while (0)

 #define nmi_enter()						\
@@ -124,8 +129,12 @@ void irq_exit_rcu(void);

 #define __nmi_exit()						\
 	do {							\
+		unsigned int nesting;				\
 		BUG_ON(!in_nmi());				\
-		__preempt_count_sub(NMI_OFFSET + HARDIRQ_OFFSET);	\
+		__preempt_count_sub(HARDIRQ_OFFSET);		\
+		nesting = __this_cpu_dec_return(nmi_nesting);	\
+		if (!nesting)					\
+			preempt_count_set(preempt_count() & ~NMI_MASK);	\
 		arch_nmi_exit();				\
 		lockdep_on();					\
 	} while (0)
diff --git a/include/linux/preempt.h b/include/linux/preempt.h
index d964f965c8ff..586f96688325 100644
--- a/include/linux/preempt.h
+++ b/include/linux/preempt.h
@@ -17,6 +17,8 @@
  *
  * - bits 0-7 are the preemption count (max preemption depth: 256)
  * - bits 8-15 are the softirq count (max # of softirqs: 256)
+ * - bits 16-19 are the hardirq count (max # of hardirqs: 16)
+ * - bit 20 is the NMI flag (no nesting count, tracked separately)
  *
  * The hardirq count could in theory be the same as the number of
  * interrupts in the system, but we run all interrupt handlers with
@@ -24,16 +26,19 @@
  * there are a few palaeontologic drivers which reenable interrupts in
  * the handler, so we need more than one bit here.
  *
+ * NMI nesting depth is tracked in a separate per-CPU variable
+ * (nmi_nesting) to save bits in preempt_count.
+ *
  *         PREEMPT_MASK:	0x000000ff
  *         SOFTIRQ_MASK:	0x0000ff00
  *         HARDIRQ_MASK:	0x000f0000
- *             NMI_MASK:	0x00f00000
+ *             NMI_MASK:	0x00100000
  * PREEMPT_NEED_RESCHED:	0x80000000
  */
 #define PREEMPT_BITS	8
 #define SOFTIRQ_BITS	8
 #define HARDIRQ_BITS	4
-#define NMI_BITS	4
+#define NMI_BITS	1

 #define PREEMPT_SHIFT	0
 #define SOFTIRQ_SHIFT	(PREEMPT_SHIFT + PREEMPT_BITS)
▲ 这段在 __nmi_enter()/__nmi_exit() 里把 NMI 嵌套深度从 preempt_count 的 4 bit 位域搬到一个独立 per-CPU 计数器 nmi_nesting。关键点:__this_cpu_inc()/dec_return() 是单 CPU 无锁操作,NMI 在同一 CPU 上不会并发;preempt_count_set(preempt_count() | NMI_MASK) 只置 1 bit 标志,in_nmi() 语义不变。为什么这么改:把 4 bit 的“冗余计数”压成 1 bit 的“布尔标志”(bit 28),腾出的空间连同原 HARDIRQ 位域被重组为 8 bit 的 HARDIRQ_DISABLE 计数(本系列 patch 02/24 引入,HARDIRQ 上移至 bits 24-27,NMI 标志在 bit 28)。注意 boqun 在 commit message 中说明:用 preempt_count_set() 清标志是为避免 __preempt_count_sub(NMI_OFFSET) 在嵌套场景下计数下溢。
逻辑点 2:中断开关解锁复用返回计数(补丁 13/24)
diff --git a/arch/arm64/include/asm/preempt.h b/arch/arm64/include/asm/preempt.h
index 0dd8221d1bef..e9f597d87413 100644
--- a/arch/arm64/include/asm/preempt.h
+++ b/arch/arm64/include/asm/preempt.h
@@ -55,20 +55,20 @@ static inline void __preempt_count_sub(int val)
 	WRITE_ONCE(current_thread_info()->preempt.count, pc);
 }

-static inline int __preempt_count_add_return(int val)
+static inline unsigned long __preempt_count_add_return(int val)
 {
-	u32 pc = READ_ONCE(current_thread_info()->preempt.count);
+	u64 pc = READ_ONCE(current_thread_info()->preempt_count);
 	pc += val;
-	WRITE_ONCE(current_thread_info()->preempt.count, pc);
+	WRITE_ONCE(current_thread_info()->preempt_count, pc);

 	return pc;
 }

-static inline int __preempt_count_sub_return(int val)
+static inline unsigned long __preempt_count_sub_return(int val)
 {
-	u32 pc = READ_ONCE(current_thread_info()->preempt.count);
+	u64 pc = READ_ONCE(current_thread_info()->preempt_count);
 	pc -= val;
-	WRITE_ONCE(current_thread_info()->preempt.count, pc);
+	WRITE_ONCE(current_thread_info()->preempt_count, pc);

 	return pc;
 }
diff --git a/include/asm-generic/preempt.h b/include/asm-generic/preempt.h
index c8683c046615..7629e23102d1 100644
--- a/include/asm-generic/preempt.h
+++ b/include/asm-generic/preempt.h
@@ -59,14 +59,14 @@ static __always_inline void __preempt_count_sub(int val)
 	*preempt_count_ptr() -= val;
 }

-static __always_inline int __preempt_count_add_return(int val)
+static __always_inline unsigned long __preempt_count_add_return(int val)
 {
 	*preempt_count_ptr() += val;

 	return *preempt_count_ptr();
 }

-static __always_inline int __preempt_count_sub_return(int val)
+static __always_inline unsigned long __preempt_count_sub_return(int val)
 {
 	*preempt_count_ptr() -= val;

diff --git a/include/linux/interrupt_rc.h b/include/linux/interrupt_rc.h
index dd4444c61330..c044dc395452 100644
--- a/include/linux/interrupt_rc.h
+++ b/include/linux/interrupt_rc.h
@@ -27,7 +27,7 @@ DECLARE_PER_CPU(struct interrupt_disable_state, local_interrupt_disable_state);
 static inline void local_interrupt_disable(void)
 {
 	unsigned long flags;
-	int new_count;
+	unsigned long new_count;

 	WARN_ON_ONCE(in_nmi());

@@ -41,9 +41,25 @@ static inline void local_interrupt_disable(void)
 	}
 }

+#ifdef CONFIG_PREEMPTION
+static inline void local_interrupt_enable_reched(unsigned long pc)
+{
+	if (pc)
+		return;
+	/* No PREEMPT_NEED_RESCHED bit? Check tif_need_resched() */
+#ifndef PREEMPT_NEED_RESCHED
+	if (!tif_need_resched())
+		return;
+#endif
+	__preempt_schedule();
+}
+#else
+static inline void local_interrupt_enable_reched(unsigned long pc) {}
+#endif
+
 static inline void local_interrupt_enable(void)
 {
-	int new_count;
+	unsigned long new_count;

 	new_count = hardirq_disable_exit();

@@ -52,15 +68,8 @@ static inline void local_interrupt_enable(void)

 		flags = raw_cpu_read(local_interrupt_disable_state.flags);
 		local_irq_restore(flags);
-		/*
-		 * TODO: re-read preempt count can be avoided, but it needs
-		 * should_resched() taking another parameter as the current
-		 * preempt count
-		 */
-#ifdef CONFIG_PREEMPTION
-		if (should_resched(0))
-			__preempt_schedule();
-#endif
+
+		local_interrupt_enable_reched(new_count);
 	}
 }
▲ 这段把 __preempt_count_{add,sub}_return() 的返回类型放宽到 unsigned long(arm64 上改为读 64 位 preempt_count),从而把 bit31 的 PREEMPT_NEED_RESCHED 也带回给调用方。关键点:新增的 local_interrupt_enable_reched(pc) 用 if (pc) return; 快速跳过——只要 preempt_count 非 0(仍在软/硬中断或其他禁用上下文),就无需考虑抢占调度;只有归 0 且(无 NEED_RESCHED 位的架构上)tif_need_resched() 置位时才调用 __preempt_schedule()。为什么这么改:should_resched(0) 内部会 READ_ONCE(preempt_count) 重读同一变量,而 hardirq_disable_exit() 刚返回过它——直接用返回值即可,省一次热路径内存读。
💬 讨论焦点
nmi_nesting 与 preempt_count_set():
- “What happened with putting this in the same line as preempt_count?”——缓存局部性:建议把
nmi_nesting与preempt_count放在同一位置(同一 cacheline),避免 NMI 路径多访问一处 per-CPU 变量。 - “While not wrong like last time; it is pretty awful. preempt_count_set() is a cmpxchg() loop.”——
preempt_count_set()是 cmpxchg 循环,在 NMI 路径上偏贵;他给出用_o = NMI_MASK + HARDIRQ_OFFSET - (preempt_count() & NMI_MASK)计算偏移、再__preempt_count_add(_o)的替代写法,可完全避开 cmpxchg。并感叹“I'm really somewhat sad that 64bit can't do better than this.”
preempt_count_set() 避免嵌套退出时计数下溢(来源:NMI 补丁 commit message,PATCH 01/24)。当前版本仍保留 preempt_count_set(),Peter 的“计算偏移避开 cmpxchg”建议尚未被采纳。irq: Optimize reschedule check in local_interrupt_enable() 回复:“As stated before; this whole thing is a mystery to me, this should not be needed.”——他对整个“计数式中断开关”基础设施的必要性存疑(此前在 v3 系列已表达过“as stated before”)。作者 Boqun Feng 随即回复:“I will drop this patch entirely per the discussion.”——即 irq 优化补丁按讨论意见整体撤回,不再进入最终 pull request。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| (补丁未提供基准数据) | — | — | — |
补丁未提供 benchmark 数据,也不含“作者自报”的量化提升。以下为基于 diff 的机制层面逻辑分析(解读(AI 分析)),非实测。
__nmi_enter()/__nmi_exit() 改造后仍要 __preempt_count_add/sub(HARDIRQ_OFFSET),并新增 __this_cpu_inc/dec(nmi_nesting) 与 preempt_count_set()(cmpxchg 循环)。因此在 on-CPU 指令数上,NMI 单次进出未必更少——Peter Zijlstra 也正是因此批评 preempt_count_set() 偏贵(解读(AI 分析):此为“为功能腾位付出的热路径代价”,作者目标是位域腾挪,不是 NMI 路径减指令)。真正的系统性收益是:preempt_count 空出 3 bit,解锁了 Rust SpinLockIrq 等新原语(功能/生态收益,off-CPU 上无直接影响)。
local_interrupt_enable()(对应 spin_unlock_irq_enable())最外层解锁时,原实现 should_resched(0) 会从内存 READ_ONCE(preempt_count) 再读一次;改造后直接用 hardirq_disable_exit() 返回的 new_count。这是典型的 on-CPU 收益(减少一次内存读/依赖链),且发生在“自旋锁解锁 + 中断恢复”这条高频路径上。注意:该补丁已按 review 撤回,最终合入版本不含此优化。
on-CPU vs off-CPU:以上均为 on-CPU(指令/内存访问)层面的收益;无 off-CPU(锁等待/唤醒延迟)数据。补丁未提供 off-CPU 数据,此项为逻辑分析(解读(AI 分析))。
🔄 方案演进
两个补丁都有明确的前序版本,且演进受 review 推动:
__this_cpu_read(nmi_nesting) == UINT_MAX,__nmi_exit 用 __preempt_count_sub(NMI_OFFSET) 清位。Peter Zijlstra review(2026-02-03):质疑 nmi_nesting 放置、
preempt_count_set() 的 cmpxchg 开销。本 pull 01/24(2026-07-31):boqun 按 Steven Rostedt 意见改 BUG_ON 条件为
>= 15,并改用 preempt_count_set() 避免嵌套退出下溢(commit message 明确标注)。
Peter Zijlstra(2026-08-03):“As stated before; this whole thing is a mystery to me, this should not be needed.”
Boqun Feng(2026-08-03):“I will drop this patch entirely per the discussion.”——撤回。
spin_lock_irqsave/restore 语义,而非在 preempt_count 里维护独立的硬中断禁用计数)。作者选择撤回 irq 优化补丁,但 NMI 位域迁出(本报告主要分析对象)仍保留在 pull request 中——它独立解决“位域紧张”问题,不依赖 irq 优化补丁。
⚠️ 风险与局限
- NMI 路径引入 cmpxchg(Peter 批评):
preempt_count_set()在__nmi_enter()/__nmi_exit()中会把 NMI 进出变成 cmpxchg 循环,理论上比原__preempt_count_add/sub()更贵。严重度 MINOR(NMI 非高频,且为功能腾位的必要代价;Peter 提供了可避开的替代写法)。(解读(AI 分析)) - nmi_nesting 与 preempt_count 分处不同 cacheline:per-CPU 变量与 thread_info/lowcore 不必然同 cacheline,NMI 路径多一处内存访问(Peter 建议合并)。严重度 MINOR。(解读(AI 分析))
- NMI 嵌套深度上限 15:
BUG_ON(nmi_nesting >= 15)是防御性断言,现实中 NMI 嵌套几乎不会超 1–2 层,风险极低;但若未来出现更深嵌套(如递归 NMI 风暴)会直接 BUG_ON 崩溃,属“失败模式”需注意。(解读(AI 分析)) - irq 补丁的返回类型放宽:
__preempt_count_{add,sub}_return()从int改为unsigned long,调用方若按int截断会丢位;本系列中其唯一调用方是hardirq_disable_{enter,exit}(),改动被限定在可控范围。若未来新增调用方,需注意位宽语义。严重度 MAJOR(若实现有误)——但该补丁已撤回,实际风险归零。
🔗 交叉引用
local_interrupt_disable()/enable() 与 hardirq_disable_enter/exit(),是 irq 优化补丁依赖的基础设施。[PATCH 02/24] preempt: Introduce HARDIRQ_DISABLE_BITS — 使用 NMI 补丁腾出的位域定义 8 bit 的
HARDIRQ_DISABLE_MASK(bits 16-23),并将 HARDIRQ 上移至 bits 24-27、NMI 标志置于 bit 28。[PATCH 14/24] rust: Introduce interrupt module — Rust 侧计数式中断开关的用户接口(SpinLockIrq 前奏)。
Lyude Paul [PATCH v17 00/16] Refcounted interrupts, SpinLockIrq for rust — NMI 补丁原始系列(cover letter)。
[GIT PULL] Rust synchronization changes for v7.3 — 本系列 cover letter(git pull 请求,base 5e601ab3615c,head 93ff5657a5f1)。
✅ 关键洞察
- 发现:两个补丁都在“preempt_count 热路径”上做减法——NMI 补丁把冗余的 4 bit NMI 嵌套计数迁到独立 per-CPU 计数器(腾位域给 HARDIRQ_DISABLE),irq 补丁让中断开关最外层解锁复用返回值、省一次 preempt_count 内存读。前者是后者(以及 Rust SpinLockIrq)的前提。
- 证据:无基准数据(补丁未提供)。机制证据来自 diff 逐字:
NMI_BITS 4→1、新增nmi_nestingper-CPU 计数、__preempt_count_{add,sub}_return()返回unsigned long、local_interrupt_enable_reched(new_count)。 - 边界:NMI 嵌套深度实际极少超过 1–2 层,上限 15 的 BUG_ON 几乎不可达;irq 优化仅对
CONFIG_PREEMPTION生效(非 PREEMPT 时local_interrupt_enable_reched()为空函数),且 arm64 等无PREEMPT_NEED_RESCHED位的架构会退回查tif_need_resched()。 - 风险 / 建议:irq 优化补丁已由作者撤回(Peter Zijlstra 对计数式中断开关整体必要性存疑);NMI 补丁仍在 pull request 中,但 Peter 关于
preempt_count_set()cmpxchg 与nmi_nesting缓存局部性的两点意见尚未解决,建议后续版本按“计算偏移 +__preempt_count_add()”和“与 preempt_count 同 cacheline”的方向修订。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。