futex: Use runtime constants for __futex_hash() hot path
💡 一句话总结
在 futex_wait() / futex_wake() 等每次操作都要先做的哈希定位热路径 __futex_hash() 上,旧实现每次都要从全局结构体 __futex_data 读哈希移位量、掩码和桶数组基址(高并发时可能命中 cache miss),且桶指针数组按配置最大节点数 MAX_NUMNODES 静态预留造成内存膨胀。补丁用内核 runtime constants 机制把这三个只读值 constify 成指令内的立即数(启动时一次性 patch 进指令,热路径不再访存全局变量),并把桶数组改为按 nr_node_ids 动态分配消除 bloat。补丁未提供基准数据(收益为逻辑分析),同方向 companion commit 在 futex hash 基准上测得最高 +39.7%(perf bench futex hash autosize,作者自报)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能 · 热路径减访存 + 内存占用缩减) |
| 性能类别 | 热路径(把只读全局数据 constify 为指令立即数,减指令/免全局变量引用) |
| 状态 | In Review(v6,截至 Linux 7.2-rc6 / 2026-08-02 未合入本地内核) |
| 当前版本 | v6(8/8)· 当前版链接 |
| 版本演进 | rfc v1(2026-01-28)→ rfc v2(2026-03-16)→ v3(2026-04-02)→ v4(2026-04-30)→ v5(2026-06-30)→ v6(2026-07-28) |
| 作者机构 | 原创:Peter Zijlstra(Intel);系列整理/arch 移植:K Prateek Nayak(AMD) |
| 提交日期 | 2026-07-28(v6) |
| 改动范围 | 2 文件(include/asm-generic/vmlinux.lds.h + kernel/futex/core.c),+29/-20 行 |
| 核心函数 | __futex_hash() / futex_init() / futex_queues() |
| 原始链接 | lore Message-ID |
📊 速览卡片
🎯 解决什么问题
futex_wait() / futex_wake() 每次进内核都要把"哪个地址上的哪个 futex"映射到内核的哈希桶,这个映射函数就是 __futex_hash()。RFC v2 cover letter 明说:"With runtime-const, the futex_queues can be allocated dynamically to only nr_node_ids slots which saves a bit of space and was the main motivation for v1"——最初动机是省内存(动态分配桶指针数组),后续演进(RFC v2 起)又叠加了"热路径免全局变量访存"这一性能目标。原补丁由 Peter Zijlstra 起草(本补丁 commit message 作者即 Peter),Prateek 整理成 8 补丁系列并补齐各架构的 runtime_const_mask_32() 支持。
futex() 系统调用 → futex_wait/wake → futex_hash() → __futex_hash()(用 jhash2 把 futex key 哈希后,按 futex_hashshift 选 NUMA 节点、按 futex_hashmask 索引桶)。机制缺陷①:
__futex_data 是一个 __read_mostly 全局结构体,哈希参数(shift/mask)和桶数组基址都放在里面,热路径每次都要 访存这个全局变量——即使值不变,每次哈希也要发一条 load 指令,cache miss 时付出内存延迟。机制缺陷②:
struct futex_hash_bucket *queues[MAX_NUMNODES] 按编译配置的最大节点数 MAX_NUMNODES(即 1 << CONFIG_NODES_SHIFT)静态预留指针数组。小系统也背着按最大配置预留的数组,Sebastian Andrzej Siewior 报告了这块 MAX_NUMNODES bloat(见补丁的 Reported-by)。
__futex_hash() 被调用的频率越高——它是 每个 futex 系统调用必经的第一步。为什么遇到缺陷:① 哈希参数是"写一次读亿万次"的只读数据,却以可变全局变量形式每次访存;cache miss 时热路径多等一次内存往返(on-CPU 延迟)。② 桶数组按 MAX_NUMNODES 预留,高节点配置的内核(CONFIG_NODES_SHIFT 较大)在低节点数机器上白白浪费内存,对容器/小内存场景不友好。
🧩 核心机制
核心逻辑点(框架 B 识别):① runtime constants 机制 ② __futex_hash() 热路径改造 ③ __futex_queues 动态分配——①是"免访存"的手段,③是"省内存"的手段,②是把两者落到热路径上。
e3c92e81711d,已合入),当前用在 fs/dcache.c(d_hash)、fs/namei.c、fs/file_table.c 等热路径。简化理解:相当于把"查表读常量"改成"把常量烧进指令里"。编译期在指令里放一个占位立即数,同时用 .pushsection 记录该立即数在指令中的位置;启动早期(代码段还没标记只读、还没被执行时)runtime_const_init() 遍历这些位置,把占位立即数 patch 成真实值。此后热路径执行这条指令时,值就在指令里,无需再读全局变量。逻辑点②:__futex_hash() 热路径改造——把
hash >> futex_hashshift 换成 runtime_const_shift_right_32(hash, __futex_shift)(移位量 patch 成立即数),把 hash & futex_hashmask 换成 runtime_const_mask_32(hash, __futex_mask)(掩码 patch 成立即数),把 futex_queues[node] 换成 futex_queues()[node](runtime_const_ptr(__futex_queues),桶基址 patch 成立即数)。逻辑点③:__futex_queues 动态分配——
__futex_queues = kcalloc(nr_node_ids, sizeof(*__futex_queues), GFP_KERNEL) 只按实际可能节点数分配指针数组,取代 queues[MAX_NUMNODES] 静态预留。三个只读值都标 __ro_after_init(init 之后进入只读页),并在 futex_init() 里用 runtime_const_init() 完成 patch。
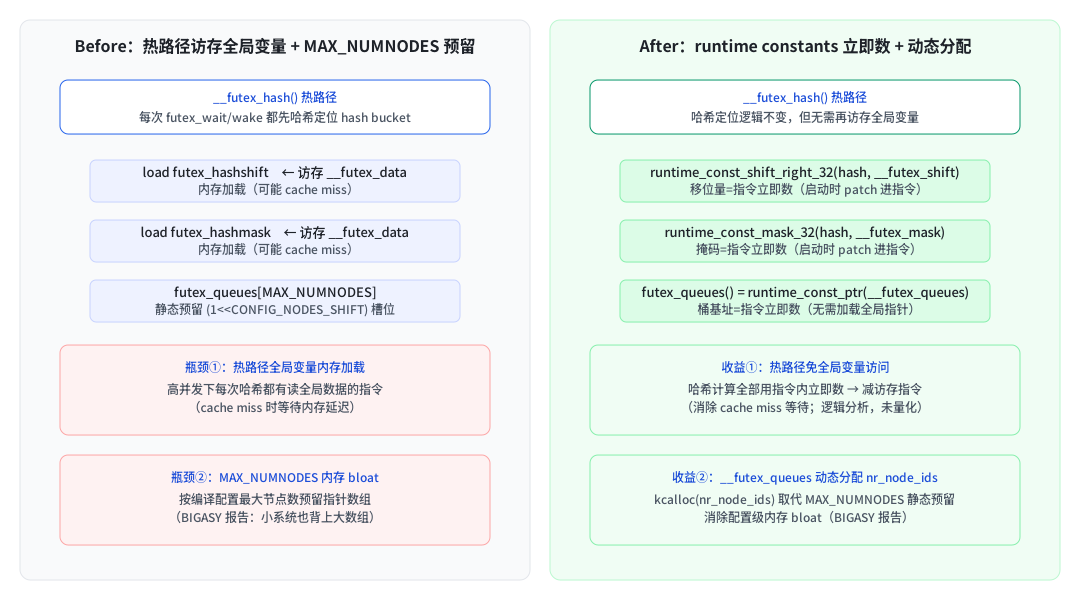
__futex_data 读 shift/mask/桶基址(访存、可能 cache miss),桶数组按 MAX_NUMNODES 静态预留;右边三个只读值 constify 成指令立即数(启动时 patch 进指令,热路径免访存),桶数组按 nr_node_ids 动态分配。来源:基于 lore 真实补丁 diff 绘制
| 逻辑点 | 操作 | 目的 |
|---|---|---|
| ① runtime const | runtime_const_init(shift/mask/ptr, ...) + vmlinux.lds.h 登记 | 把只读值烧进指令立即数(免访存的前提) |
| ② 热路径改造 | runtime_const_shift_right_32 / mask_32 / ptr | 哈希计算免全局变量访存(减指令/减 cache miss) |
| ③ 动态分配 | __futex_queues = kcalloc(nr_node_ids, ...) | 消除 MAX_NUMNODES 静态预留 bloat(省内存) |
🔬 关键代码
按核心逻辑点组织,每点选最能体现的 diff(diff 逐字来自 lore v6 补丁):
diff --git a/kernel/futex/core.c b/kernel/futex/core.c
@@ -48,23 +48,19 @@
 #include <vdso/futex.h>

+#include <asm/runtime-const.h>
+
 #include "futex.h"
 #include "../locking/rtmutex_common.h"

-/*
- * The base of the bucket array and its size are always used together
- * (after initialization only in futex_hash()), so ensure that they
- * reside in the same cacheline.
- */
-static struct {
-	unsigned long            hashmask;
-	unsigned int		 hashshift;
-	struct futex_hash_bucket *queues[MAX_NUMNODES];
-} __futex_data __read_mostly __aligned(2*sizeof(long));
+static u32 __futex_mask __ro_after_init;
+static u32 __futex_shift __ro_after_init;
+static struct futex_hash_bucket **__futex_queues __ro_after_init;

-#define futex_hashmask	(__futex_data.hashmask)
-#define futex_hashshift	(__futex_data.hashshift)
-#define futex_queues	(__futex_data.queues)
+static __always_inline struct futex_hash_bucket **futex_queues(void)
+{
+	return runtime_const_ptr(__futex_queues);
+}
▲ 为什么这么改:旧的 __futex_data 把 shift/mask/桶数组打包进一个全局结构体(原注释特意让它们同 cacheline)。新代码拆成三个独立的 __ro_after_init 变量,配合 runtime_const_ptr() 取桶基址——启动 patch 后这条 mov $实际地址, %reg 就是一条带立即数的指令,不再读全局变量。旧注释"确保同 cacheline"之所以不再需要,是因为值直接进指令、根本不访存。
@@ -395,13 +391,13 @@ __futex_hash(union futex_key *key, struct futex_private_hash *fph, struct futex_
 	 * NOTE: this isn't perfectly uniform, but it is fast and
 	 * handles sparse node masks.
 	 */
-		node = (hash >> futex_hashshift) % nr_node_ids;
+		node = runtime_const_shift_right_32(hash, __futex_shift) % nr_node_ids;
 		if (!node_possible(node)) {
 			node = find_next_bit_wrap(node_possible_map.bits, nr_node_ids, node);
 		}
 	}

-	return &futex_queues[node][hash & futex_hashmask];
+	return &futex_queues()[node][runtime_const_mask_32(hash, __futex_mask)];
▲ 为什么这么改:这是热路径的核心两行。旧代码 hash >> futex_hashshift 和 hash & futex_hashmask 都要先 load 全局变量的值;新代码把移位量/掩码 patch 成立即数,指令变成 shrl $N, %reg / andl $M, %reg——移位/掩码操作的"数"直接嵌在指令里。换节点选桶逻辑不变(no functional changes),只是去掉了对全局变量的依赖。
@@ -2019,10 +2015,21 @@ static int __init futex_init(void)
 	hashsize = max(4, hashsize);
 	hashsize = roundup_pow_of_two(hashsize);
 #endif
-	futex_hashshift = ilog2(hashsize);
+	__futex_mask = hashsize - 1;
+	__futex_shift = ilog2(hashsize);
 	size = sizeof(struct futex_hash_bucket) * hashsize;
 	order = get_order(size);

+	__futex_queues = kcalloc(nr_node_ids, sizeof(*__futex_queues), GFP_KERNEL);
+
+	runtime_const_init(shift, __futex_shift);
+	runtime_const_init(mask,  __futex_mask);
+	runtime_const_init(ptr,   __futex_queues);
+
+	barrier();
+
+	BUG_ON(!futex_queues());
+
 	for_each_node(n) {
 		struct futex_hash_bucket *table;
@@ -2036,10 +2043,9 @@ static int __init futex_init(void)
 		for (i = 0; i < hashsize; i++)
 			futex_hash_bucket_init(&table[i]);

-		futex_queues[n] = table;
+		futex_queues()[n] = table;
 	}

-	futex_hashmask = hashsize - 1;
 	pr_info("futex hash table entries: %lu (%lu bytes on %d NUMA nodes, total %lu KiB, %s).\n",
▲ 为什么这么写:三个 runtime_const_init() 把占位立即数 patch 成真实值;kcalloc(nr_node_ids, ...) 只按实际可能节点数分配桶指针数组。关键一行:barrier()——这是 v6 根据 Intel 测试机器人(GCC14 构建)报告加的,防止编译器把后续 futex_queues()[n] = table 对 runtime const 的读取重排到 runtime_const_init() 之前(若重排,会在 patch 完成前读到占位值)。BUG_ON(!futex_queues()) 兜底 kcalloc 失败。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| 高并发 futex 哈希定位热路径 | 多核(理论分析,补丁未附基准环境) | 每次哈希访存全局 shift/mask/桶基址 | 值在指令内立即数,免访存(未量化) |
| 低节点数机器跑高 CONFIG_NODES_SHIFT 内核 | 小内存 / 容器场景 | queues[MAX_NUMNODES] 静态预留 | kcalloc(nr_node_ids) 动态分配(省内存,未量化) |
说明:本补丁系列未提供基准数据(作者在 RFC/cover letter 中未附 perf bench 数字)。收益为逻辑分析(解读(AI 分析),依据框架 A 从执行路径推断):
① on-CPU 收益:哈希计算从"load 全局变量 + 移位/掩码"变为"立即数移位/掩码",少一条 load,潜在 cache miss 消失——这是减指令/减内存等待的 on-CPU 收益。
② 内存收益:MAX_NUMNODES → nr_node_ids 消除配置级静态预留,属静态数据/堆内存占用下降(非 on/off-CPU 延迟类别)。
③ 需要强调:补丁未提供 off-CPU 数据;本改动也不改变 futex 哈希桶本身的锁行为,off-CPU 收益不在此补丁范围内。
同方向已合入的 companion commit(a734d9fca84e "futex: Optimize futex hash bucket access patterns",Peter Zijlstra,2026-06,属另一优化)用 perf bench futex hash 测出:SKL 双路 112 线程下 shared(16k) 1,571,857 → 1,641,435(+4.4%)、autosize(512) 646,390 → 903,371(+39.7%)(作者自报,未独立验证)。它证明 futex hash 路径确实性能敏感,可作为本补丁收益空间的上界参考。
🔄 方案演进
本系列从 rfc v1 到 v6 的演进(基于 lore 各版本 cover letter 真实 changelog):
rfc v2(2026-03-16):用 runtime constants 避免"动态分配后多一次指针解引用"的开销;引入
runtime_const_mask_32() 及 arm64/riscv/s390/x86 各 arch 实现(x86 由 Peter 提供,其余为 Prateek 对照 gcc 反汇编移植)。v3(2026-04-02):摘掉 RFC 标签;Heiko 对 s390 给出 Ack;按 Davidlohr(David)建议重排 patch 顺序、把 "&" 移出内联汇编块便于编译器优化。
v4(2026-04-30):按 Sashiko/Catalin 建议去掉
lm_alias();新增 Patch 4 把 RISC-V magic 字面量改为 #define(Guo);宏变量名回退为 __ret 约定(Sashiko)。v5(2026-06-30):ARM64 掩码操作改用
ubfx、RISC-V 改用 srli+slli(Charlie、Samuel 建议),每次掩码 ARM64 省 2 条指令、RISC-V 省 1 条;收集 Catalin/Charlie 的 tag。v6(2026-07-28):加
barrier() 防编译器把 runtime const 使用重排到初始化前(Intel 测试机器人、Sashiko);加 __fls() 前的零值检查(Sashiko);并入 Peter 的 S-o-b;收集 Charlie 的 Reviewed/Tested-by;rebase 到最新 tip。
futex_init() 里后续的 runtime const 读取重排到 runtime_const_init() 之前。v6 用 barrier() 显式阻断。Sashiko:
__fls(0) 被编译器"聪明地"优化掉(v6 cover letter 记录):__fls(val) 在 val 为 0 时结果未定义,编译器可能据此认为 val 非 0,从而把后续 BUG_ON(!val && ...) 优化成跳过 !val 检查。v6 在调用前显式检查 val 为 0。Sashiko:弱内存序架构可能读到 runtime const 的占位值(v4 changelog):作者回应认为不成立——变量在 early boot 初始化,BSP 上的本地访问按序提交,占位值不会泄漏;支持 runtime constants 的架构由
runtime_const_init() 在 patch 后提供屏障。Charlie Jenkins:RISC-V 掩码指令优化留待后续(178366995930.1208691.2993932866462893112.b4-review@b4;v6 cover letter):若掩码能编进立即数,可用
andi+nop 替代 slli+srli,Charlie 已给出优化方向,本系列合入后单独发。Samuel Holland:
__futex_mask 恒为 GENMASK(N,0) 形态(v4 cover letter 记录):据此 ARM64/RISC-V 可分别用单条 ubfx / slli+srli 实现掩码——该建议在 v5 落地。Sebastian Andrzej Siewior:报告 MAX_NUMNODES bloat(本补丁
Reported-by):桶指针数组按配置最大节点数静态预留造成内存浪费,是动态分配的直接动因。
注:以上 review 观点均来自本系列各版本 cover letter 的 changelog 原文转述,观点来源已链接到对应 lore 消息或报告。
⚠️ 风险与局限
runtime_const_mask_32() 需要各架构实现;不支持的架构走 asm-generic 的 dummy 实现(退化为直接读 __ro_after_init 变量,行为等价,无性能收益但有正确性兜底)。新 patch 化架构若实现有误,可能 patch 错误立即数(解读(AI 分析):风险点在 arch 侧 runtime_const_mask_32() 的指令编码)。编译器重排:runtime constants 依赖"patch 前不得使用"的时序;v6 用
barrier() 挡编译器重排,但 barrier() 只约束编译器、不约束 CPU 乱序——不过 runtime_const_init() 内部含 patch 所需屏障(commit message 原话),且 init 在 BSP 上、用户态启动前完成(解读(AI 分析):启动路径单核执行,风险低)。内存分配失败:
kcalloc(nr_node_ids, ...) 可能失败,BUG_ON(!futex_queues()) 直接 panic——与旧静态数组"必然成功"相比是新的失败模式(解读(AI 分析):init 阶段 GFP_KERNEL 失败概率极低,但语义从"不可能失败"变为"失败即 panic")。多核扩展性:本补丁不改哈希桶/锁的并发结构,桶锁竞争行为不变;扩展性收益主要来自省掉的访存指令与 cache miss,随 futex 频率线性放大,不引入新串行化(解读(AI 分析))。
🔗 交叉引用
20260227161841.GH606826,x86 的 runtime_const_mask_32() 实现与 futex 热路径 constify 的原型futex: Optimize futex hash bucket access patterns — 同作者(Peter Zijlstra)2026-06 已合入的 companion commit,私有哈希引用计数重构,perf bench futex hash 最高 +39.7%(作者自报)
runtime constants: add x86 architecture support — runtime constants 基础设施(Linus Torvalds,2024-06,Linux 6.10),本补丁依赖的底层机制
PATCH v6 0/8 cover letter — 系列问题/动机/演进/讨论摘要
✅ 关键洞察
- 发现:把 futex 哈希热路径的三个只读值用 runtime constants 烧进指令立即数,消除每次哈希对全局变量的访存,并把桶指针数组从
MAX_NUMNODES静态预留改为nr_node_ids动态分配,一举解决"热路径访存"与"内存 bloat"两个问题 - 证据:本补丁未提供基准数据;同方向已合入的 companion commit(a734d9fca84e)在 SKL 双路 112 线程 perf bench futex hash 上测得 +4.4%(shared)/+39.7%(autosize),作者自报未独立验证,可作为收益空间上界参考
- 边界:不支持的架构走 dummy 实现退化为直接读
__ro_after_init变量(正确性等价、无性能收益);收益随 futex 操作频率放大,单线程低频场景接近 no-op - 风险 / 建议:重点 review arch 侧
runtime_const_mask_32()的指令编码正确性;kcalloc失败 panic 为新增失败模式;建议合入后补一组perf bench futex hash实测数据验证收益假设
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。