sched/cache: Reduce the overhead of task_cache_work by only scan the visisted cpus
💡 一句话总结
cache-aware 调度(CONFIG_SCHED_CACHE)会周期性地为每个进程寻找「最偏爱的 LLC(最后一级缓存域)」,靠的是 task_cache_work() 每隔 llc_epoch_period(默认 10ms)扫描全系统所有 CPU 来计算各缓存域的占用热度。在多 NUMA 大机器上(如 384 CPU)这种「全量扫描」绝大部分落在从未跑过该进程、或早已超时的 CPU 上,造成显著开销。本补丁给每个进程的 mm_struct 加一个 visited_cpus 位图,只记录「该进程真正运行过、且近期仍在运行的 CPU」,task_cache_work() 只在这张位图上扫描,并淘汰超过 llc_epoch_affinity_timeout(5 个 epoch,约 50ms)未访问的 CPU。作者自报:Redis(valkey-benchmark)场景扫描 CPU 数从 384 降到 14~16,task_cache_work 在 perf 中的周期占比从 0.81% 降到 0.02%,p99 延迟从「相对 baseline 恶化 -25.68%」回收到「仅 -1.14%」。属于优化补丁(performance),状态 In Review。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(performance)——降低 cache-aware 调度热路径 task_cache_work() 的扫描开销 |
| 状态 | In Review(v9,2026-07-31 提交,尚未合入主线) |
| 当前版本 | v9 · v9 补丁链接 |
| 版本演进 |
v1(04-15 前)→
v2(04-14)→
v3(04-23)→
v4(06-18)→
v5(07-09)→
v6(07-17)→
v7(07-20)→
v8(07-23,+46/-56)→
v9(07-31,当前版,+47/-57) (各版本链接来自 v9 cover letter 的 Changes history,均为 lore 官方 URL;主分析对象为任务指定 message-id 对应的 v6 补丁 1/2) |
| 作者机构 | Luo Gengkun(luogengkun2@huawei.com,华为) |
| 提交日期 | 2026-07-17(v6)~ 2026-07-31(v9) |
| 改动范围 | include/linux/mm_types.h + include/linux/sched.h + kernel/sched/fair.c,+46/-56 行(v8),3 文件;当前版 v9 为 +47/-57 |
| 核心函数 | task_cache_work() / fraction_mm_sched() / account_mm_sched() |
| 原始链接 | lore Message-ID(v6 补丁 1/2) |
📊 速览卡片
🎯 解决什么问题
CONFIG_SCHED_CACHE)由 Intel Tim Chen / Chen Yu 系列补丁引入主线(基础设施 commit df0d98475954,2026-04-01;特性合并 a26d9208c137,2026-05-19)。它让进程「偏爱」某个 LLC 缓存域:把进程的线程尽量聚到同一个 LLC 里,减少跨缓存域访问的 miss。作者在 v9 cover letter 中描述问题原文:"The overhead of task_cache_work() is high, especially in multi-NUMA systems. Currently, task_cache_work() tries to find the pref_llc by scanning all CPUs in the system. However, most of these scans are meaningless, such as those for CPUs that have never been visited or were accessed a long time ago."(多 NUMA 系统下 task_cache_work() 开销很高,它扫描全系统所有 CPU 来找偏爱 LLC,但大部分扫描毫无意义——那些 CPU 从未被访问或早已超时)。
task_cache_work() 是每进程的延迟工作(task_work),由 task_tick_cache() 在每 tick 触发,但通过 next_scan 门控确保每 llc_epoch_period(默认 10ms)只执行一次。它的目标是:遍历每个 CPU 的 LLC 调度域 sched_domain_span(sd),对域内每个 rq 调用 fraction_mm_sched()(在 cpu_epoch_lock 下取锁 + 更新几何级数占用率),累加出该 LLC 域的总占用 a_occ,最终把「占用最高的 LLC 域」选为进程新的 pref_llc(mm->sc_stat.cpu)。问题在于:它在每个 epoch 都对全系统所有 CPU 做一次取锁 + 算术。在 384 CPU 的多 NUMA 服务器上,每次扫描 384 个 rq,其中绝大多数 rq 上该进程从未运行过(占用率恒为 0),属于纯浪费。
- 负载特征:多实例部署(multi-instance)场景下,每个 redis-server / valkey-server 进程只跑在一小撮 CPU 上,但它的
task_cache_work()每 10ms 就要把全系统几百个 CPU 全部扫一遍。 - 硬件配置:AMD 多路 / 多 CCD 服务器,NUMA 节点多、CPU 总数大(trace 显示 scan=384),跨缓存域访问成本高,正是 cache-aware 调度想优化的对象。
- 因果:cache-aware 调度本身在 Redis 上把 p99 从 0.436ms 恶化到 0.554ms(-25.68%,作者自报)——恶化主因正是
task_cache_work()的周期性全量扫描(perf 中占 0.81% 周期)。这个「防缓存 miss」的机制因为自身扫描开销反而拖累了延迟敏感型负载。
🧩 核心机制
核心思路一句话:把「全系统所有 CPU」的扫描范围,收敛成「该进程最近真正运行过的 CPU」。实现上引入 per-mm 的 visited_cpus 位图 + per-CPU 的 epoch_last_visit 时间戳,并在 fraction_mm_sched() 中做超时淘汰。
- 记访问(
account_mm_sched()):进程在某 CPU 的 rq 上运行时,会做运行时记账。补丁在此处更新pcpu_sched->epoch_last_visit = epoch并cpumask_set_cpu(cpu, visited_cpus)—— 表示「这个 CPU 最近被该进程用过」。 - 淘汰超时(
fraction_mm_sched()):扫描时先__update_mm_sched(),再判断(rq->cpu_epoch - epoch_last_visit) > llc_epoch_affinity_timeout(超 5 个 epoch 未访问)就把该 CPU 从visited_cpus清掉并返回 0 —— 既淘汰了过期 CPU,又让返回值天然「无贡献」。 - 只扫访问过(
task_cache_work()):外层先cpumask_and(cpus, cpu_online_mask, visited_cpus),内层for_each_cpu_and(i, sched_domain_span(sd), cpus)—— 遍历每个 LLC 域时只处理「同时位于该域且被访问过」的 CPU。
mm->sc_stat.visited_cpus 改为用本地 cpus 副本,缩短读取 pcpu_sched 的竞态窗口。
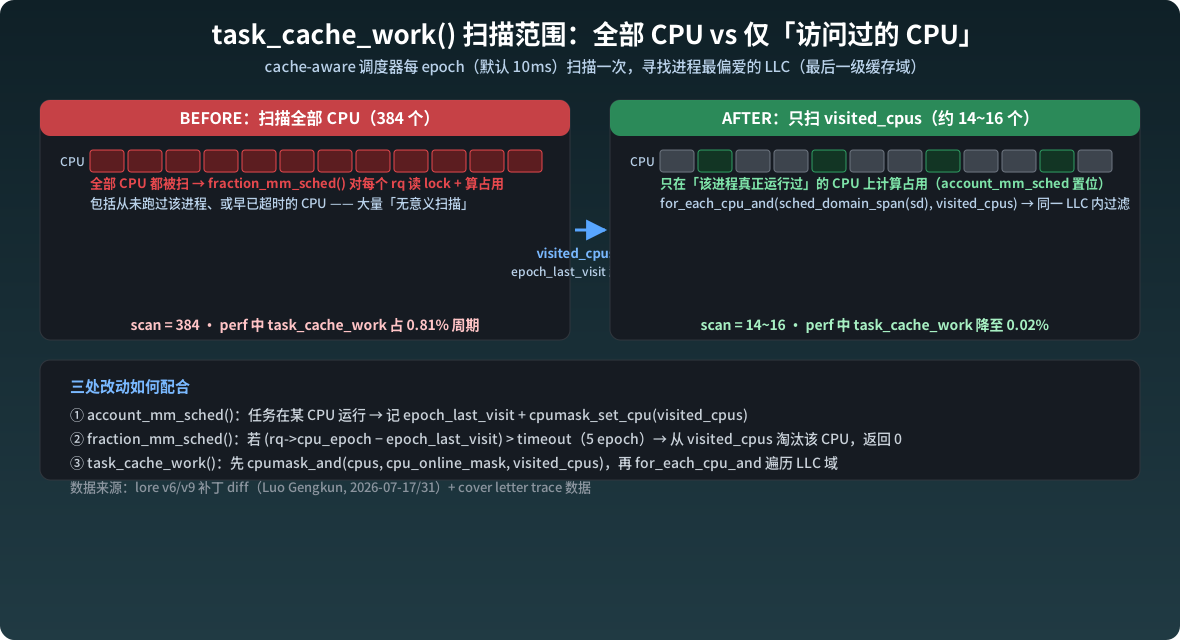
来源:基于 lore v6/v9 补丁 diff 与 cover letter trace 数据绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 记访问 | account_mm_sched() 中更新 epoch_last_visit + cpumask_set_cpu() | 标记「该进程最近在此 CPU 运行过」 |
| 淘汰超时 | fraction_mm_sched() 中 cpu_epoch - epoch_last_visit > timeout → 清位图 + 返回 0 | 移走过期 CPU,避免长期无效扫描 |
| 只扫访问过 | task_cache_work() 中 cpumask_and(cpus, online, visited_cpus) + for_each_cpu_and() | 把扫描集合收敛到真实访问过的 CPU |
| 生命周期 | mm_alloc_sched_noprof() 分配 / mm_destroy_sched() 释放位图 | 位图随进程生命周期分配/回收 |
🔬 关键代码
以下 diff 逐字取自 lore v9 补丁 1/2(20260731024417.1106503-2,当前版;v6 的核心逻辑与之相同,v8 起删除 get_scan_cpumasks())。
diff --git a/include/linux/mm_types.h b/include/linux/mm_types.h
index b18c2b2e7d2c..35559079e4d4 100644
--- a/include/linux/mm_types.h
+++ b/include/linux/mm_types.h
@@ -1620,6 +1620,11 @@ static inline int mm_alloc_sched_noprof(struct mm_struct *mm)
 	if (!pcpu_sched)
 		return -ENOMEM;

+	if (!zalloc_cpumask_var(&mm->sc_stat.visited_cpus, GFP_KERNEL)) {
+		free_percpu(pcpu_sched);
+		return -ENOMEM;
+	}
+
 	mm_init_sched(mm, pcpu_sched);
 	return 0;
 }
@@ -1630,6 +1635,7 @@ static inline void mm_destroy_sched(struct mm_struct *mm)
 {
 	free_percpu(mm->sc_stat.pcpu_sched);
 	mm->sc_stat.pcpu_sched = NULL;
+	free_cpumask_var(mm->sc_stat.visited_cpus);
 }
 #else /* !CONFIG_SCHED_CACHE */

diff --git a/include/linux/sched.h b/include/linux/sched.h
index 373bcc0598d1..b461a71a65da 100644
--- a/include/linux/sched.h
+++ b/include/linux/sched.h
@@ -2388,6 +2388,7 @@ static __always_inline int task_mm_cid(struct task_struct *t)
 struct sched_cache_time {
 	u64 runtime;
 	unsigned long epoch;
+	unsigned long epoch_last_visit;
 };

 struct sched_cache_stat {
@@ -2398,6 +2399,7 @@ struct sched_cache_stat {
 	unsigned long next_scan;
 	unsigned long footprint;
 	int cpu;
+	cpumask_var_t visited_cpus;
 } ____cacheline_aligned_in_smp;

 #else
diff --git a/kernel/sched/fair.c b/kernel/sched/fair.c
index d78467ec6ee1..2bb370b38b79 100644
--- a/kernel/sched/fair.c
+++ b/kernel/sched/fair.c
@@ -1585,6 +1585,7 @@ void mm_init_sched(struct mm_struct *mm,
 		pcpu_sched->runtime = 0;
 		/* a slightly stale cpu epoch is acceptible */
 		pcpu_sched->epoch = rq->cpu_epoch;
+		pcpu_sched->epoch_last_visit = rq->cpu_epoch;
 		epoch = rq->cpu_epoch;
 	}

@@ -1635,13 +1636,23 @@ static inline void __update_mm_sched(struct rq *rq,
 	}
 }

-static unsigned long fraction_mm_sched(struct rq *rq,
-				       struct sched_cache_time *pcpu_sched)
+static unsigned long fraction_mm_sched(int cpu,
+				       struct mm_struct *mm)
 {
+	struct sched_cache_time *pcpu_sched =
+		per_cpu_ptr(mm->sc_stat.pcpu_sched, cpu);
+	struct rq *rq = cpu_rq(cpu);
+
 	guard(raw_spinlock_irqsave)(&rq->cpu_epoch_lock);

 	__update_mm_sched(rq, pcpu_sched);

+	/* Skip the rq that has not been hit for a long time */
+	if ((rq->cpu_epoch - pcpu_sched->epoch_last_visit) > llc_epoch_affinity_timeout) {
+		cpumask_clear_cpu(cpu, mm->sc_stat.visited_cpus);
+		return 0;
+	}
+
 	/*
 	 * Runtime is a geometric series (r=0.5) and as such will sum to twice
 	 * the accumulation period, this means the multiplcation here should
@@ -1711,6 +1722,9 @@ void account_mm_sched(struct rq *rq, struct task_struct *p, s64 delta_exec)
 		pcpu_sched->runtime += delta_exec;
 		rq->cpu_runtime += delta_exec;
 		epoch = rq->cpu_epoch;
+		pcpu_sched->epoch_last_visit = epoch;
+		if (!cpumask_test_cpu(cpu_of(rq), mm->sc_stat.visited_cpus))
+			cpumask_set_cpu(cpu_of(rq), mm->sc_stat.visited_cpus);
 	}

 	/*
@@ -1761,51 +1775,6 @@ static void task_tick_cache(struct rq *rq, struct task_struct *p)
 	}
 }

-static void get_scan_cpumasks(cpumask_var_t cpus, struct task_struct *p)
-{
-#ifdef CONFIG_NUMA_BALANCING
-	int cpu, curr_cpu, nid, pref_nid;
-
-	if (!static_branch_likely(&sched_numa_balancing))
-		goto out;
-
-	cpu = READ_ONCE(p->mm->sc_stat.cpu);
-	if (cpu != -1)
-		nid = cpu_to_node(cpu);
-	curr_cpu = task_cpu(p);
-
-	/*
-	 * Scanning in the preferred NUMA node is ideal. However, the NUMA
-	 * preferred node is per-task rather than per-process. It is possible
-	 * for different threads of the process to have distinct preferred
-	 * nodes; consequently, the process-wide preferred LLC may bounce
-	 * between different nodes. As a workaround, maintain the scan
-	 * CPU mask to also cover the process's current preferred LLC and the
-	 * current running node to mitigate the bouncing risk.
-	 * TBD: numa_group should be considered during task aggregation.
-	 */
-	pref_nid = p->numa_preferred_nid;
-	/* honor the task's preferred node */
-	if (pref_nid == NUMA_NO_NODE)
-		goto out;
-
-	cpumask_or(cpus, cpus, cpumask_of_node(pref_nid));
-
-	/* honor the task's preferred LLC CPU */
-	if (cpu != -1 && !cpumask_test_cpu(cpu, cpus) && nid != NUMA_NO_NODE)
-		cpumask_or(cpus, cpus, cpumask_of_node(nid));
-
-	/* make sure the task's current running node is included */
-	if (!cpumask_test_cpu(curr_cpu, cpus))
-		cpumask_or(cpus, cpus, cpumask_of_node(cpu_to_node(curr_cpu)));
-
-	return;
-
-out:
-#endif
-	cpumask_copy(cpus, cpu_online_mask);
-}
-
 static inline void update_avg_scale(u64 *avg, u64 sample)
 {
 	int factor = per_cpu(sd_llc_size, raw_smp_processor_id());
@@ -1845,7 +1814,7 @@ static void task_cache_work(struct callback_head *work)
 	if (time_before(now, next_scan))
 		return;

-	/* only 1 thread is allowed to scan */
+	/* elect a single scanner per epoch */
 	if (!try_cmpxchg(&mm->sc_stat.next_scan, &next_scan,
 			 now + max_t(unsigned long,
 				     READ_ONCE(llc_epoch_period), 1)))
@@ -1866,7 +1835,18 @@ static void task_cache_work(struct callback_head *work)
 	scoped_guard (cpus_read_lock) {
 		guard(rcu)();

-		get_scan_cpumasks(cpus, p);
+		/*
+		 * Data race: While evaluating the visited_cpus without
+		 * a lock, a CPU could be concurrently set by
+		 * account_mm_sched(), meaning the scan might skip the newly
+		 * visited CPU if the bit changes during the scan. This is
+		 * a deliberate trade-off between accuracy and efficiency:
+		 * locking would prevent this race but incur extra overhead.
+		 * The missed runtime contribution is negligible because it
+		 * implies this process hasn't run on that CPU for a long
+		 * time, and will be captured in the next cycle.
+		 */
+		cpumask_and(cpus, cpu_online_mask, mm->sc_stat.visited_cpus);

 		for_each_cpu(cpu, cpus) {
 			/* XXX sched_cluster_active */
@@ -1877,19 +1857,21 @@ static void task_cache_work(struct callback_head *work)
 			if (!sd)
 				continue;

-			for_each_cpu(i, sched_domain_span(sd)) {
-				occ = fraction_mm_sched(cpu_rq(i),
-						per_cpu_ptr(mm->sc_stat.pcpu_sched, i));
+			for_each_cpu_and(i, sched_domain_span(sd), cpus) {
+				cur = rcu_dereference_all(cpu_rq(i)->curr);
+				if (cur && !(cur->flags & (PF_EXITING | PF_KTHREAD)) &&
+				    cur->mm == mm)
+					nr_running++;
+
+				occ = fraction_mm_sched(i, mm);
+				if (occ == 0)
+					continue;
+
 				a_occ += occ;
 				if (occ > m_occ) {
 					m_occ = occ;
 					m_cpu = i;
 				}
-
-				cur = rcu_dereference_all(cpu_rq(i)->curr);
-				if (cur && !(cur->flags & (PF_EXITING | PF_KTHREAD)) &&
-				    cur->mm == mm)
-					nr_running++;
 			}

 			/*
--
2.34.1
① 数据结构的「记录 + 淘汰」基础
sched_cache_time 增加 epoch_last_visit,sched_cache_stat 增加 visited_cpus 位图(cpumask_var_t,动态分配避免 per-process 在 NR_CPUS 大时内存膨胀——这是 v6 相对 v5 的关键改动)。mm_alloc_sched_noprof() 负责 zalloc_cpumask_var(),mm_destroy_sched() 负责 free_cpumask_var(),配齐生命周期。
② 谁在「记录访问」:account_mm_sched()
进程在 rq 上运行并记账时,epoch_last_visit = epoch + cpumask_set_cpu(cpu_of(rq), visited_cpus)。关键:这是补丁唯一的「置位」点,且带 cpumask_test_cpu() 预检(v2 起加入)——CPU 已在位图里就不重复 set,避免 C2C(cache-to-cache)开销。
③ 淘汰 + 跳过:fraction_mm_sched() 改签名
函数签名从 (struct rq *rq, struct sched_cache_time *pcpu_sched) 改为 (int cpu, struct mm_struct *mm),内部自取 per_cpu_ptr() 与 cpu_rq()。加的超时判断是核心:(rq->cpu_epoch - pcpu_sched->epoch_last_visit) > llc_epoch_affinity_timeout 时清位图并返回 0——过期 CPU 不再贡献占用,下一次扫描也不会再进它。v4 引入的 epoch_timeout(后更名 epoch_last_visit)就是为此:单靠 epoch 不行,因为 fraction_mm_sched() 每次调用都会刷新 epoch,无法判断「多久没真访问」。
④ 只扫访问过的 CPU:task_cache_work() 收窄集合
外层 cpumask_and(cpus, cpu_online_mask, visited_cpus) 直接把扫描集合从「全在线 CPU」收窄成「访问过的 CPU」。内层 for_each_cpu_and(i, sched_domain_span(sd), cpus) 确保「即使跨节点 LLC 拓扑,也只处理访问过的 CPU」(v6 改动 2 的意图)。v8 删除 get_scan_cpumasks() 是因为 visited_cpus 已提供精确集合;v9 改用本地 cpus 副本是为了缩小读取竞态窗口(见下方 review)。cur / nr_running 统计移到 fraction_mm_sched() 之前并加 occ == 0 提前 continue,避免对淘汰 CPU 做无效累加。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| Redis p99 延迟 @400K rps,NUMA balancing 关闭 | AMD 服务器,384 CPU | 0.554ms(cache-aware 无本系列,相对 baseline 恶化 -25.68%) | 0.441ms(-1.14% vs baseline,作者自报) |
| task_cache_work 周期占比(perf top -e cycles:k) | 同上 | 0.81% | 0.02%(作者自报) |
| 单次扫描 CPU 数(sched_cache_scan trace) | 同上 | 384 | 14 / 13 / 16(作者自报 trace) |
| Redis p99 @400K rps,NUMA balancing 开启 | 同上 | 0.454ms(-3.89% vs baseline) | 0.442ms(-1.14% vs baseline,作者自报) |
| task_cache_work 周期占比(NUMA balancing 开启) | 同上 | 0.13% | 0.03%(作者自报) |
说明:数据均来自 v9 cover letter,作者自报,未独立验证。基线 = 无 cache-aware 调度;「改进前」= 有 cache-aware 但无本系列(schedcache);「改进后」= 有 cache-aware + 本系列(schedcache_visit)。Hackbench 对比显示本系列对 cache-aware 调度精度基本无影响(多数配置 IMPROVED,个别配置小幅 REGRESSED,如 threads/2/2 组 -7.00%、threads/1/20 组相对 baseline -5.68%——后者是 cache-aware 相对 baseline 的回归,非本系列引入)。
- on-CPU(计算侧)收益:本补丁减少的是
task_cache_work()的指令/取锁/算术次数(384 → 14~16 个 rq),是典型的 on-CPU 开销降低。每 epoch 省下的就是「对从未访问的 rq 取cpu_epoch_lock+ 做几何级数累加」的时间,perf 占比 0.81% → 0.02% 直接体现。 - off-CPU(等待侧)视角:间接收益——
cpu_epoch_lock是跨 rq 的锁,扫描 384 个 rq 会反复拿/放不同 CPU 的锁,与其他 CPU 的记账路径产生锁竞争;扫描集合变小后,锁足迹也随之缩小,间接缓解跨核锁争用(解读(AI 分析):补丁未提供 off-CPU/锁竞争数据,此项为逻辑推断)。 - 对延迟的意义:Redis 这类延迟敏感负载,p99 从 -25.68% 回收到 -1.14%,本质是把「cache-aware 防 miss 带来的收益」从「被自身扫描开销吃掉」恢复出来。
🔄 方案演进 + 讨论焦点
- v1(04-15 前):初版,引入 visited_cpus 概念 + 独立的
llc_epoch_visited_timeout,用 static key 控制。 - v2(04-14):set/clear 前加
cpumask_test_cpu()预检避免 C2C 开销;timeout 用 static key 优化。 - v3(04-23):移除 static key、默认启用;复用
llc_epoch_affinity_timeout替代新引入的 timeout;把 epoch 差计算移入fraction_mm_sched()避免与__update_mm_sched()的竞态;末尾重置work->next防同一进程多线程并发扫描。 - v4(06-18):rebased 到 master;引入
epoch_timeout淘汰过期 CPU(不能依赖 epoch,因为它被fraction_mm_sched()周期性刷新);nr_running累加移到fraction_mm_sched()前;加 debug patch 展示扫描数。 - v5(07-09):恢复
get_scan_cpumasks()(避免违反 NUMA_BALANCING 约束);用for_each_cpu_and()过滤 LLC 域内 CPU。 - v6(07-17,任务指定 message-id):改用
cpumask_var_t动态分配(防NR_CPUS大时 per-process 内存膨胀);LLC 域 span 直接与 visited_cpus 相交(防跨节点 LLC 拓扑下漏扫);epoch_timeout更名epoch_last_visit;__update_mm_sched()移到超时判断前执行。 - v7(07-20):在
task_cache_work()加注释澄清 visited_cpus 设置/读取间的竞态。 - v8(07-23,+46/-56):删除
get_scan_cpumasks()——visited_cpus 已提供精确扫描集合。 - v9(07-31,当前版,+47/-57):内层循环改用
for_each_cpu_and(i, sched_domain_span(sd), cpus)(用本地副本而非直接读 visited_cpus),缩短读取mm->sc_stat.pcpu_sched的竞态窗口;更新注释为「每 epoch 选举单个扫描器」。
- Chen Yu(yu.c.chen@intel.com)v6 review(07-17):指出 visited_cpus 需要
zalloc_cpumask_var()/free_cpumask_var()配对(v6 已具备);建议在account_mm_sched()或task_cache_work()加注释澄清竞态——"It's a trade-off between accuracy and efficiency - locking would fix it but at the cost of extra overhead IMO, and the up-to-date visited_cpus could be read properly in the next invoke of task_cache_work()"。来源:b86112e7。 - Tim Chen(tim.c.chen@linux.intel.com)v7 review(07-20):提出最尖锐的竞态场景——CPU A 读
epoch_last_visit看到「超时」→ 准备清位图;CPU B 恰好同时account_mm_sched()刷新epoch_last_visit并 set 位图;A 随后cpumask_clear_cpu()把 B 刚 set 的位抹掉,导致刚访问过的 CPU 被误删。他建议smp_mb()+ 双检,但自嘲 "This fix is ugly and there's probably a better way";同时建议既然 visited_cpus 已提供精确集合,可删除get_scan_cpumasks()(v8 采纳)。来源:ee643d72。 - Chen Yu 讨论收束(07-31):关于
task_tick_cache()中mm->sc_stat.epoch的「avoid moving backwards」检查在锁外是否有效,Chen Yu 指出该逻辑本意是防df0d98475954的负超时差,且经c1e7fe5e75ed改为(long)强转后,epoch 略微回退「not a big deal」。这条讨论围绕的是既有特性的 epoch 语义,与本补丁的 visited_cpus 强相关(都在 epoch 语义上做超时判断)。来源:84f81335。 - 未决:Tim Chen 提出的「读超时 → 清位图」与「并发刷新 + set」的竞态,作者用 v9 的本地副本
cpus+ 注释声明「可接受的下一次捕获」来缓解,未采用 barrier 方案;是否会被维护者最终接受仍有待后续版本/讨论。
⚠️ 风险与局限
- visited_cpus 竞态:Tim Chen 指出的「超时淘汰 vs 并发置位」竞态仍在——某 CPU 刚被进程跑到(set 位图),若扫描器读到旧
epoch_last_visit判定超时并 clear,会把该 CPU 的贡献漏掉一个 epoch。作者判定影响可忽略(进程刚跑过的 CPU 下轮会再置位),但这是精度 vs 效率的取舍,不是严格正确。解读(AI 分析):漏掉一个 epoch 的贡献,只影响 pref_llc 选择延迟一个周期,不会造成错误迁移,风险可控。 - NUMA balancing 交互:v5 曾恢复
get_scan_cpumasks()以避免违反 NUMA_BALANCING 约束(scan 范围要覆盖进程的 preferred node / 当前运行 node),v8 又将其删除——删除后是否完整保留了 NUMA 语义、会不会在 NUMA balancing 开启时漏扫需要关注的 node,是 review 中值得关注的回归点(解读(AI 分析))。 - 冷启动/足迹扩展:若进程的 CPU 足迹随时间扩大(迁移到新 node),visited_cpus 里只有旧 CPU,新 node 的 CPU 需等进程实际跑上去后才被纳入,pref_llc 更新可能滞后(解读(AI 分析):这是「只扫访问过的」设计固有代价)。
- 多核扩展性:visited_cpus 是 per-mm 位图,扫描 O(visited),不随全系统核数增长而增长,扩展性反而更优;无新增全局串行化。
- 内存:per-mm 动态分配
cpumask_var_t,进程数巨大时仍有额外内存,但 v6 改为动态分配已把NR_CPUS大时的固定膨胀消除。 - Hackbench 回归:cover letter 中 schedcache vs schedcache_visit 有个别配置小幅 REGRESSED(如 threads/2/2 -7.00%、threads/2/4 -3.55%、threads/4/2 -2.68%),作者总体判定「不影响 cache-aware 调度精度」,但小配置下存在波动。
🔗 交叉引用
task_cache_work() 由该系列引入(2026-04-01)a26d9208c137 Merge branch 'sched/cache' — cache-aware 调度特性并入主线的合并点(2026-05-19)
Tim Chen v7 review — visited_cpus 竞态分析 + 建议删除 get_scan_cpumasks(Intel cache-aware 系列作者)
Chen Yu v6 review — zalloc/free_cpumask_var 配对 + 竞态取舍说明(Intel)
同站:sched/cache: honor migrate_llc_task semantics(08-03) — 同为 cache-aware 调度系列的另一条补丁(主动负载均衡路径语义补齐),可对照阅读
714059f79ff0 sched/cache: Handle moving single tasks to/from their preferred LLC — cache-aware 调度系列配套 commit
✅ 关键洞察
- 发现:cache-aware 调度的周期性全量扫描是其在多 NUMA 大机上「防 miss 反而拖累延迟」的根因;本补丁用 per-mm
visited_cpus位图 +epoch_last_visit超时淘汰,把扫描范围从全系统收敛到「进程真实访问过的 CPU」。 - 证据:作者自报(未独立验证)——扫描 CPU 数 384→14~16,
task_cache_work周期占比 0.81%→0.02%(NUMA balancing 关闭)与 0.13%→0.03%(开启),Redis p99 从相对 baseline 恶化 -25.68% 回收到 -1.14%。 - 边界:仅在
CONFIG_SCHED_CACHE生效;进程 CPU 足迹远小于全系统 CPU 数的多实例场景收益最大;单 CPU 足迹≈全系统的场景(如均匀打散的高并发)收益趋近于无。 - 风险 / 建议:Tim Chen 指出的「超时淘汰 vs 并发置位」竞态仍未根治(作者选择精度取舍 + 注释声明);v5↔v8 对
get_scan_cpumasks()的去留反映 NUMA balancing 语义权衡,建议维护者确认删除后 NUMA 约束仍被满足;Hackbench 个别小配置有波动,建议补多节点大 CPU 数的扩展性验证。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。